Claude Fable 5.2 : prix et accès
Anthropic a sorti Claude Fable 5.2 le 9 novembre 2026, avec Claude Mythos 5.2. C'est le même modèle sous 2 noms. Fable porte des garde-fous en cybersécurité et en biologie, ce qui permet de l'ouvrir à tous. Mythos est réservé à des organisations vérifiées.
D'après l'annonce d'Anthropic, il répond jusqu'à 30 % plus vite que Fable 5.1, pour un prix en baisse sur l'API.
| Question | Réponse |
|---|---|
| Qui y a accès | Les offres payantes : Pro, Max, Ultra, Team et Enterprise. |
| Max et Ultra | Inclus, jusqu'à 50 % du quota hebdomadaire. |
| Pro et sièges standard de Team | À l'usage, en crédits. Inclus du 9 au 16 novembre 2026 (offre de lancement). |
| Où l'utiliser | L'application Claude, Cowork et Claude Code (version 2.1.321 ou plus récente). |
| Prix sur l'API | 8 $ par million de tokens en entrée, 40 $ en sortie (10 $ et 50 $ pour Fable 5.1). |
Si vous avez un abonnement Pro, c'est la semaine pour l'essayer. Jusqu'au 16 novembre à 23 h 59, heure du Pacifique (le 17 à 8 h 59 à Paris), Fable est inclus dans votre quota, dans la limite de 50 %. Ensuite, il repasse en crédits d'usage. Le détail est dans l'aide de Claude sur l'offre de lancement et dans la page des modèles Fable par abonnement.
Fable consomme votre quota plus vite que les autres modèles. Gardez un œil sur la page d'utilisation de vos paramètres.
Benchmark : 41 % de vrais projets de freelances réussis de bout en bout
Une ligne du tableau de résultats d'Anthropic porte un nom peu connu : Remote Labor Index. Fable 5.2 y obtient 41,3 %.
Ce test a été créé par Scale AI et le Center for AI Safety, et publié en octobre 2025. Il réunit 240 projets réellement commandés à des freelances, dans 23 domaines : développement, design, architecture, analyse de données. Les freelances qui les ont réalisés ont été payés 143 991 $ au total. La méthode est décrite par Scale AI et dans l'article de recherche.
La règle du test : l'IA reçoit le brief du client, travaille seule et rend son livrable. Le projet compte comme réussi si le résultat atteint le niveau qu'un client accepterait d'un professionnel. Seul un projet rendu en entier compte.
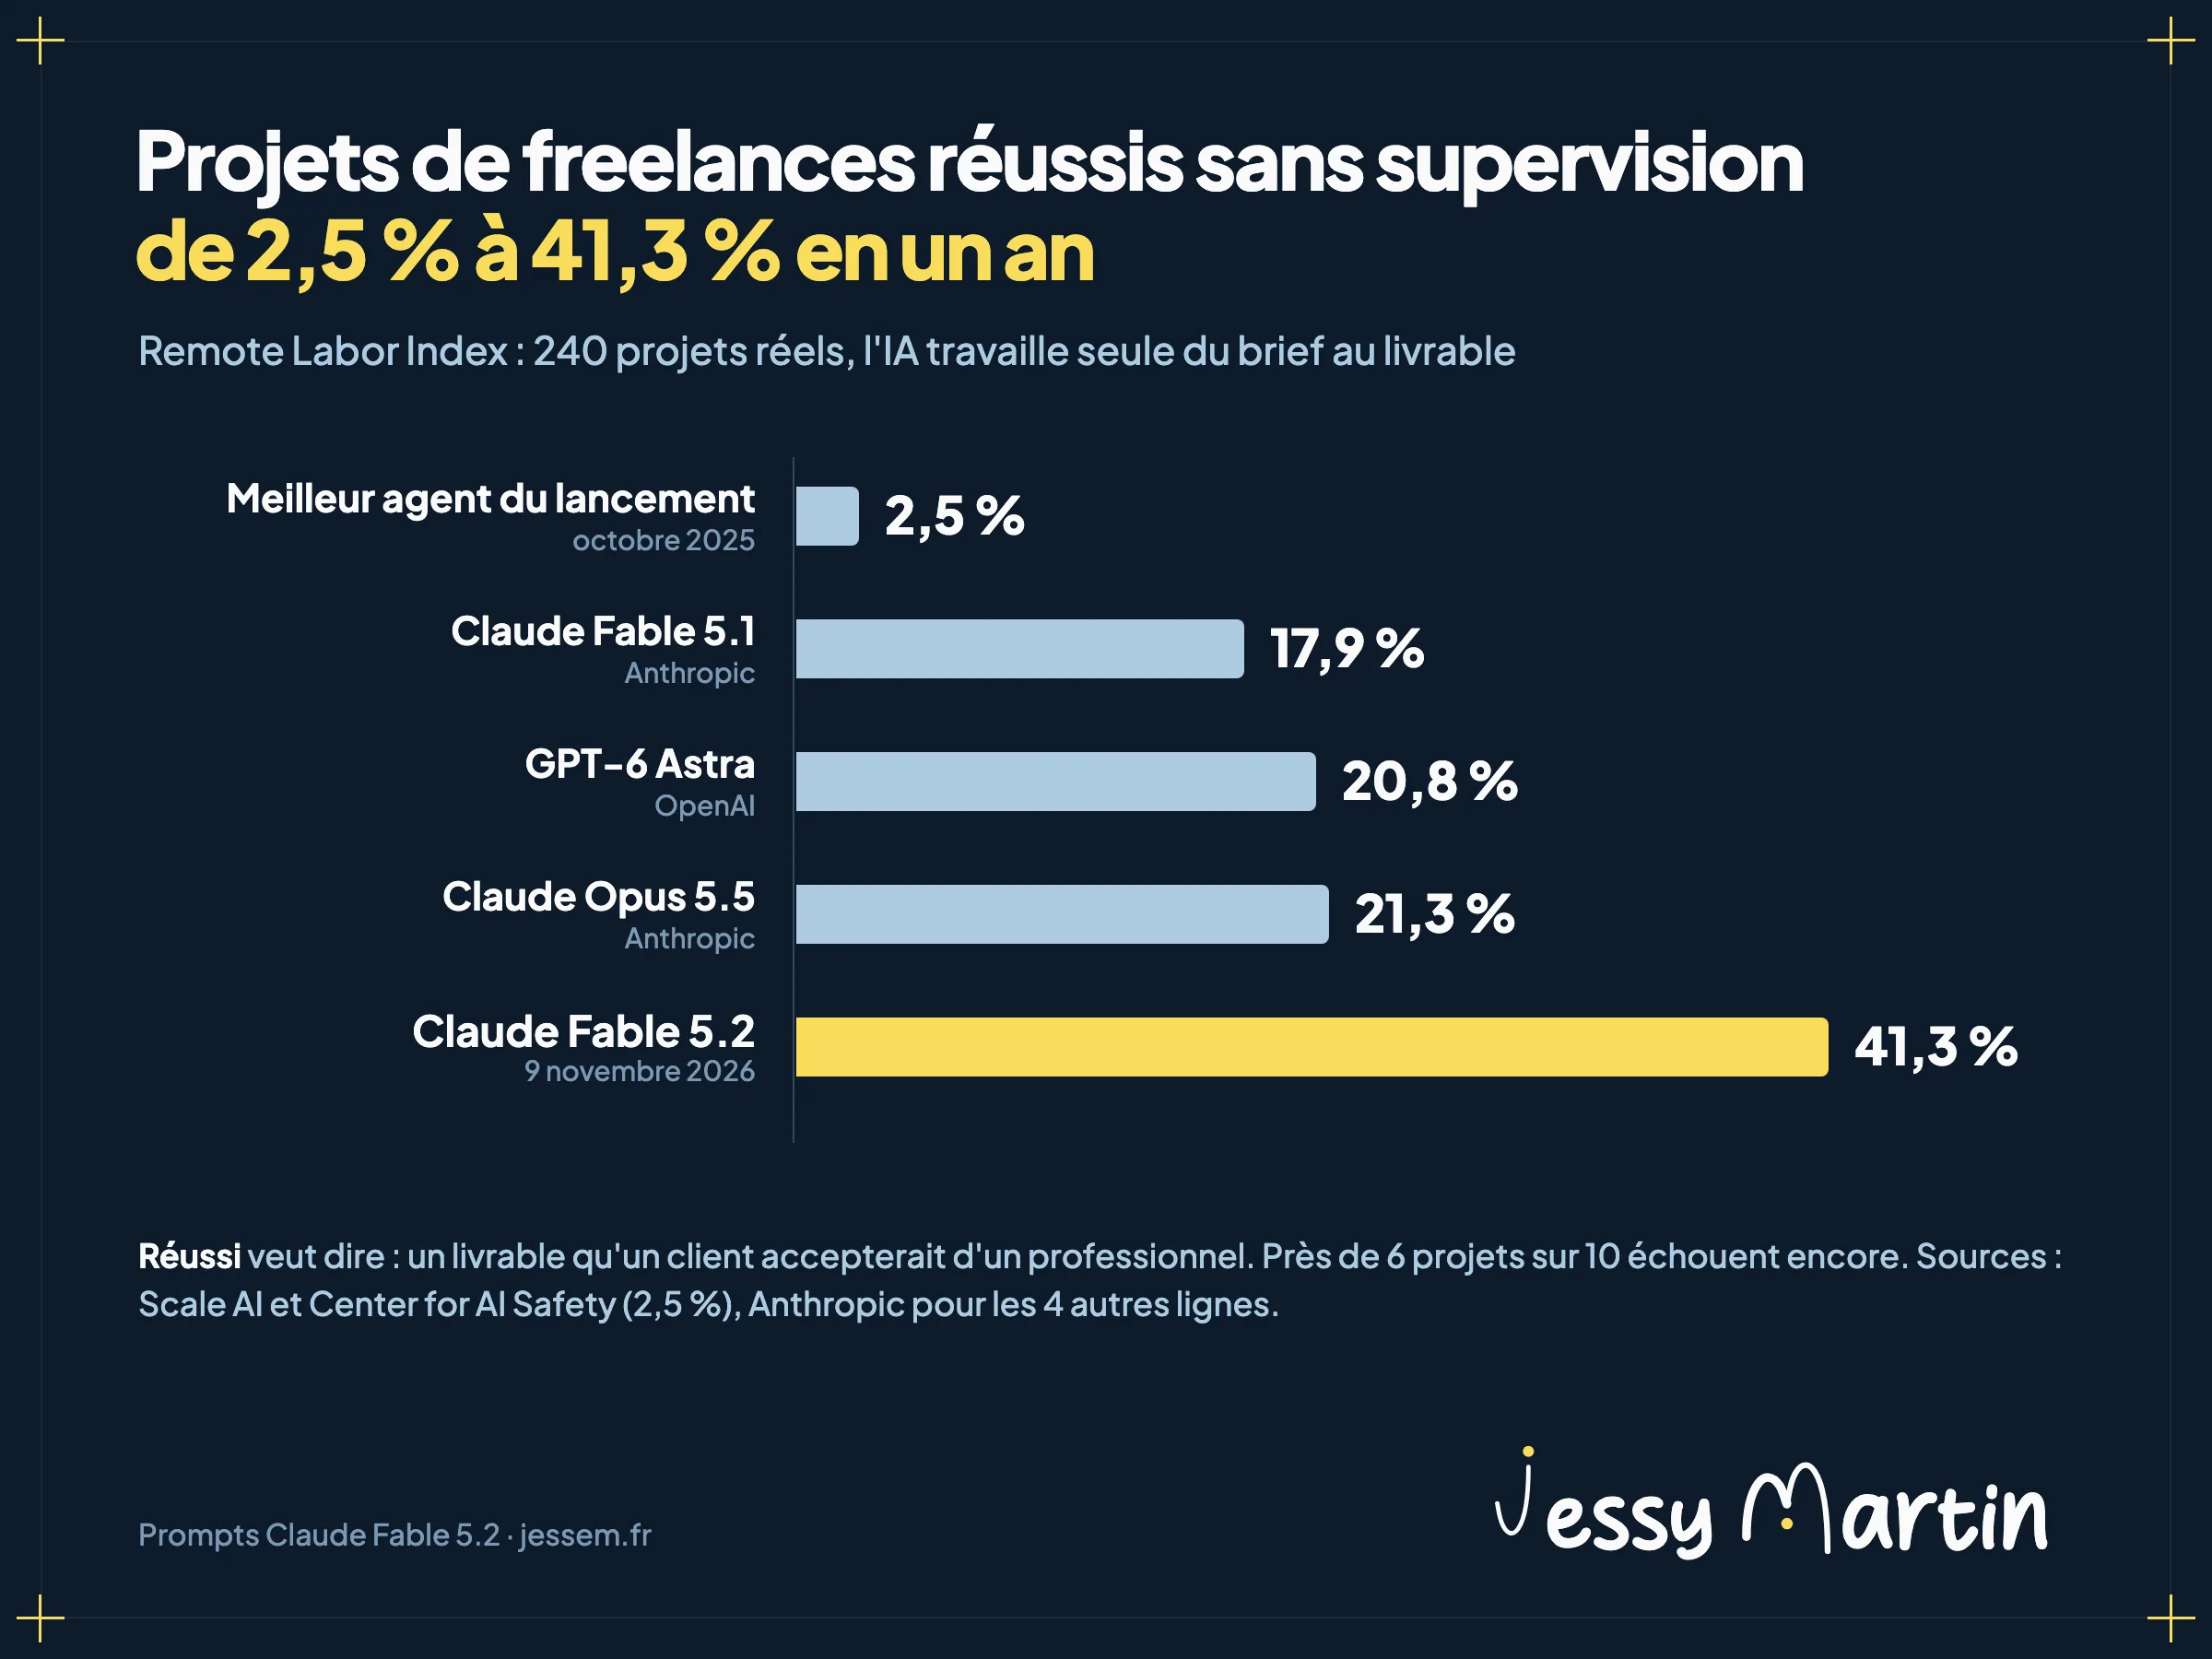
| Modèle ou agent | Projets réussis | Source |
|---|---|---|
| Meilleur agent au lancement du test (octobre 2025) | 2,5 % | Scale AI |
| Claude Fable 5.1 | 17,9 % | Anthropic |
| GPT-6 Astra | 20,8 % | Anthropic |
| Claude Opus 5.5 | 21,3 % | Anthropic |
| Claude Fable 5.2 | 41,3 % | Anthropic |
Les 4 dernières lignes viennent du tableau publié sur la page de Claude Fable 5.2. Le score a presque doublé entre Opus 5.5 et Fable 5.2. Il y a un an, le meilleur agent réussissait 2,5 % de ces projets.
Ce chiffre a 2 limites. Ces résultats sont publiés par Anthropic, avec Fable 5.2 réglé sur l'effort « high ». Et près de 6 projets sur 10 échouent encore. Un projet réussi reste loin d'un métier : le test ne mesure ni la relation avec le client ni la responsabilité du résultat.
Les démos qui circulent depuis lundi vont dans le même sens. Dans une vidéo de la chaîne Claude, le modèle conçoit un assistant vocal de salon qui fonctionne : carte électronique, boîtier et logiciel. D'après l'annonce, la demande tenait en un paragraphe. Sur Reddit, un fil présente un jeu de tir jouable construit dans Unreal Engine avec un prompt de 3 lignes, d'après son auteur.
Pour une équipe marketing, cela touche ce que vous confiez à un prestataire avec un brief : une landing page ou une analyse de données. Vous pouvez maintenant le tenter avec ce modèle. Votre travail se déplace vers le brief en amont et la relecture en aval.
Orchestrer une tâche difficile avec Fable 5.2 : la méthode hub and spoke
Sur la page du modèle, Anthropic présente Fable 5.2 comme son meilleur agent chef de file. D'après ses tests, il mène un travail d'ingénierie ambigu pendant des jours et coordonne des centaines de sous-agents. Un ingénieur de Datadog cité dans l'annonce le compare à un commandant d'incident, qui envoie des modèles plus rapides chercher les premiers signaux et coordonne le tout.
C'est ainsi que je l'emploie sur une tâche difficile. Seul, il lit tout lui-même, remplit son contexte et facture chaque page parcourue au prix fort. En chef d'orchestre, il garde ce qui demande du jugement et distribue le reste.
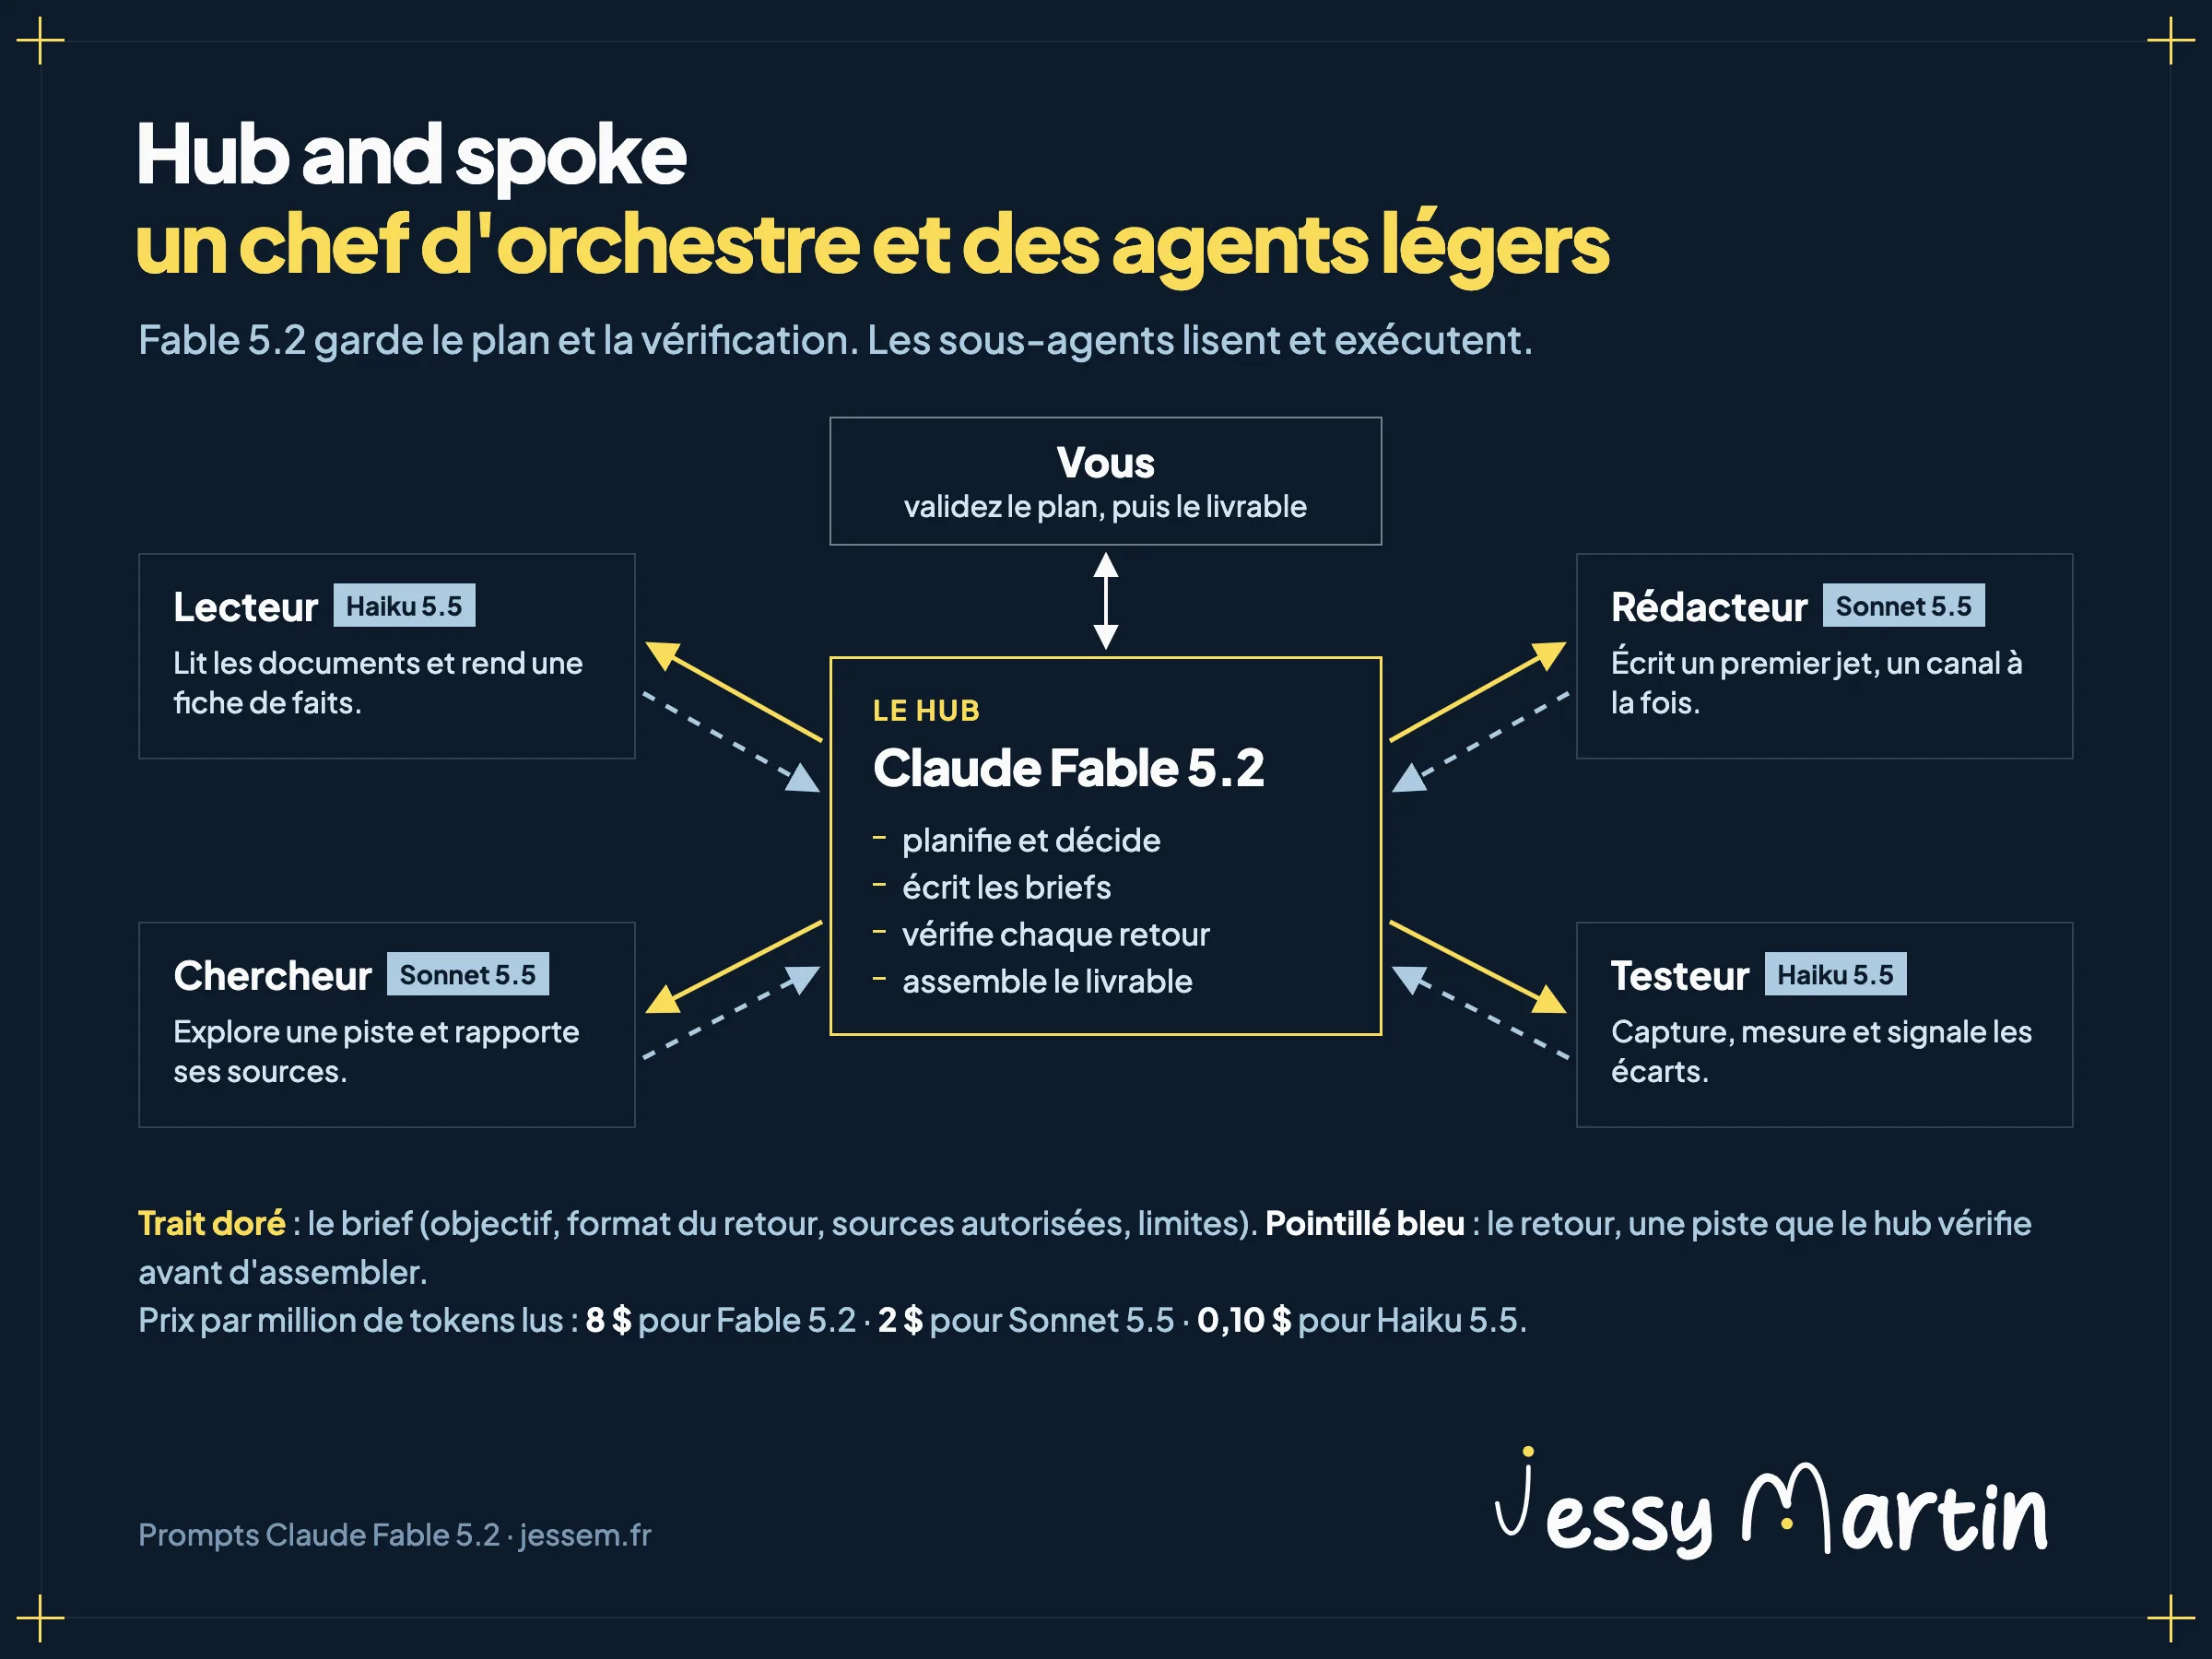
Cette organisation s'appelle le hub and spoke : le moyeu et les rayons d'une roue. Au centre, le hub. Fable 5.2 planifie, écrit les briefs, vérifie chaque retour et assemble le livrable. Autour, les rayons. Ce sont des sous-agents sur des modèles plus légers, chacun avec une mission étroite et sa propre fenêtre de contexte. Ils lisent, cherchent, rédigent un premier jet ou testent, puis rendent un résultat condensé.
Pourquoi des sous-agents plus légers
Le prix d'abord. D'après les tarifs de l'API, un million de tokens lus coûte 8 $ avec Fable 5.2, 2 $ avec Sonnet 5.5 et 0,10 $ avec Haiku 5.5 sur les requêtes courantes. Une lecture confiée à Haiku coûte 80 fois moins cher.
La qualité ensuite. Anthropic a mesuré l'effet sur son propre système de recherche : un agent chef de file épaulé par des sous-agents plus légers a fait 90,2 % de mieux qu'un agent seul du même niveau, sur son évaluation interne. Chaque sous-agent explore sa piste dans un contexte neuf, puis condense ce qu'il a trouvé. Le récit est dans l'article d'Anthropic sur son système multi-agents.
Le revers est écrit dans le même article : un système multi-agents consomme environ 15 fois plus de tokens qu'une conversation. Il se réserve aux tâches dont la valeur justifie la dépense.
Quand orchestrer
| Orchestrez avec des sous-agents | Gardez un seul agent |
|---|---|
| La tâche est large : beaucoup de sources ou de fichiers à lire. | La modification est rapide et ciblée. |
| Les sous-tâches sont indépendantes les unes des autres. | Chaque étape dépend de la précédente. |
| Une étape produit un volume de texte dont seul le résumé vous sert. | Vous échangez souvent avec lui en cours de route. |
| Le livrable vaut plusieurs heures de travail humain. | La réponse tient en une conversation. |
Ces critères viennent de la documentation des sous-agents de Claude Code et de l'article d'Anthropic. La dernière ligne est la mienne.
Mes 6 règles d'orchestration
- Le hub garde le jugement. Le plan, les arbitrages, la vérification et l'écriture finale restent chez lui. Un rayon reçoit une tâche qui se décrit en une phrase.
- Un brief en 4 points par sous-agent. Son objectif, le format de son retour, les sources et les outils autorisés, les limites de sa tâche. C'est la liste d'Anthropic, et elle se vérifie à l'usage. Un sous-agent démarre sans l'historique de la conversation : il ne connaît que ce brief et les fichiers d'instructions du projet.
- Une équipe à la taille de la tâche. Anthropic donne ses repères : 1 agent pour un fait simple, 2 à 4 sous-agents pour une comparaison, plus de 10 pour une recherche large. En octobre, j'en ai lancé 6 en parallèle sur 121 fiches à enrichir. Le quota de recherches web de la session, partagé entre eux, était épuisé vers la 8e fiche de chaque lot. Depuis, je compte les ressources partagées avant de fixer le nombre de rayons.
- Un modèle et un effort par rôle. Sans réglage, un sous-agent de Claude Code tourne sur le modèle de la conversation : vos rayons travaillent alors sur Fable, au prix de Fable. Début novembre, la limite hebdomadaire de mon modèle le plus fort a coupé net un sous-agent en plein chantier. Depuis, l'exécution et les relectures courantes tournent sur Sonnet. Le modèle le plus fort garde la relecture finale et les sujets sensibles.
- Chaque retour est une piste à vérifier. En août, un sous-agent d'audit m'a rendu un rapport détaillé et chiffré. La section Programme de mes 13 fiches de formation était vide, écrivait-il. Chaque fiche contenait 5 ou 8 séquences. Il avait lu la phrase d'introduction et conclu. Le hub recompte donc lui-même, à la source, tout ce qu'il s'apprête à affirmer.
- 2 points d'arrêt humains. Vous validez le plan avant l'exécution, puis le livrable avant qu'il sorte. Entre les 2, les règles qui ne doivent jamais céder passent par du code : la méthode est dans Contrôler ses agents IA avec les hooks de Claude Code.
La règle 4 se règle dans un fichier. Chaque sous-agent de Claude Code a le sien, dans le dossier .claude/agents/, avec son modèle, son effort et ses outils.
---
name: lecteur-sources
description: Lit un lot de documents et rend une fiche de faits par document
tools: Read, Glob, Grep
model: haiku
effort: low
---

Tu lis les documents qu'on te confie. Pour chacun, rends une fiche :
les 5 faits les plus utiles, chacun avec sa page ou sa ligne.
Rapporte les faits tels qu'ils sont écrits. Les conclusions reviennent
à l'orchestrateur.
Si une information manque, écris « absent ».
Ce lecteur n'a que 3 outils de lecture : il ne peut rien modifier. La commande /tasks affiche le modèle de chaque sous-agent en cours. Un sous-agent est un agent complet, avec les 5 composantes décrites dans Qu'est-ce qu'un agent IA.
Prompter Fable 5.2 : 5 règles tirées du guide officiel
Anthropic a publié un guide de prompting propre à ce modèle. Il est écrit pour des développeurs. 5 de ses conseils changent aussi le résultat d'un travail marketing.
- Retirez vos vieilles consignes. Fable 5.2 suit les instructions de très près. Une règle de style rigide ou une précaution oubliée dans un fichier de mémoire sera appliquée à la lettre. Relisez ce que vous traînez depuis les anciens modèles.
- Dites-lui que le projet est le sien. Dans les tests d'Anthropic sur de petites tâches de code, cette phrase a fait fusionner le code répété dans environ la moitié des essais, contre moins d'un sur 10 sans elle. Le modèle a aussi fait des changements que personne n'avait demandés. Relisez ce qu'il a touché.
- Demandez-lui d'aller au bout. Sur une tâche longue, il lui arrive de s'arrêter avant la fin, avec la liste de ce qui reste. Un paragraphe qui lui demande de finir a réduit ces arrêts de moitié environ, pour 30 % de tokens en plus.
- Validez par une phrase précise. Écrivez « oui, publie la page sur l'environnement de test » là où vous auriez écrit « continue ». Le modèle applique vos règles d'approbation telles qu'elles sont écrites.
- Laissez-le travailler et exigez un récapitulatif. Il peut enchaîner de longues séries d'actions sans rien vous écrire. Demandez une ligne d'annonce au départ et un récapitulatif final qui se lit seul.
Le guide ajoute 2 réglages utiles à l'orchestration. L'effort « low » convient aux sous-agents rapides, et « high » aux tâches longues et difficiles du hub. Et les précautions s'accumulent d'un agent à l'autre. Dans les tests d'Anthropic, une seule note « ne jamais réessayer » oubliée dans le contexte a fait tomber les nouvelles tentatives de presque toutes à 4 sur 10. Nettoyez ce que vos agents se transmettent.
Le socle d'orchestration à coller avant chaque mission
Un prompt d'orchestration a 2 étages. Le socle porte la méthode et ne change pas d'une mission à l'autre. Le brief de mission porte le métier.
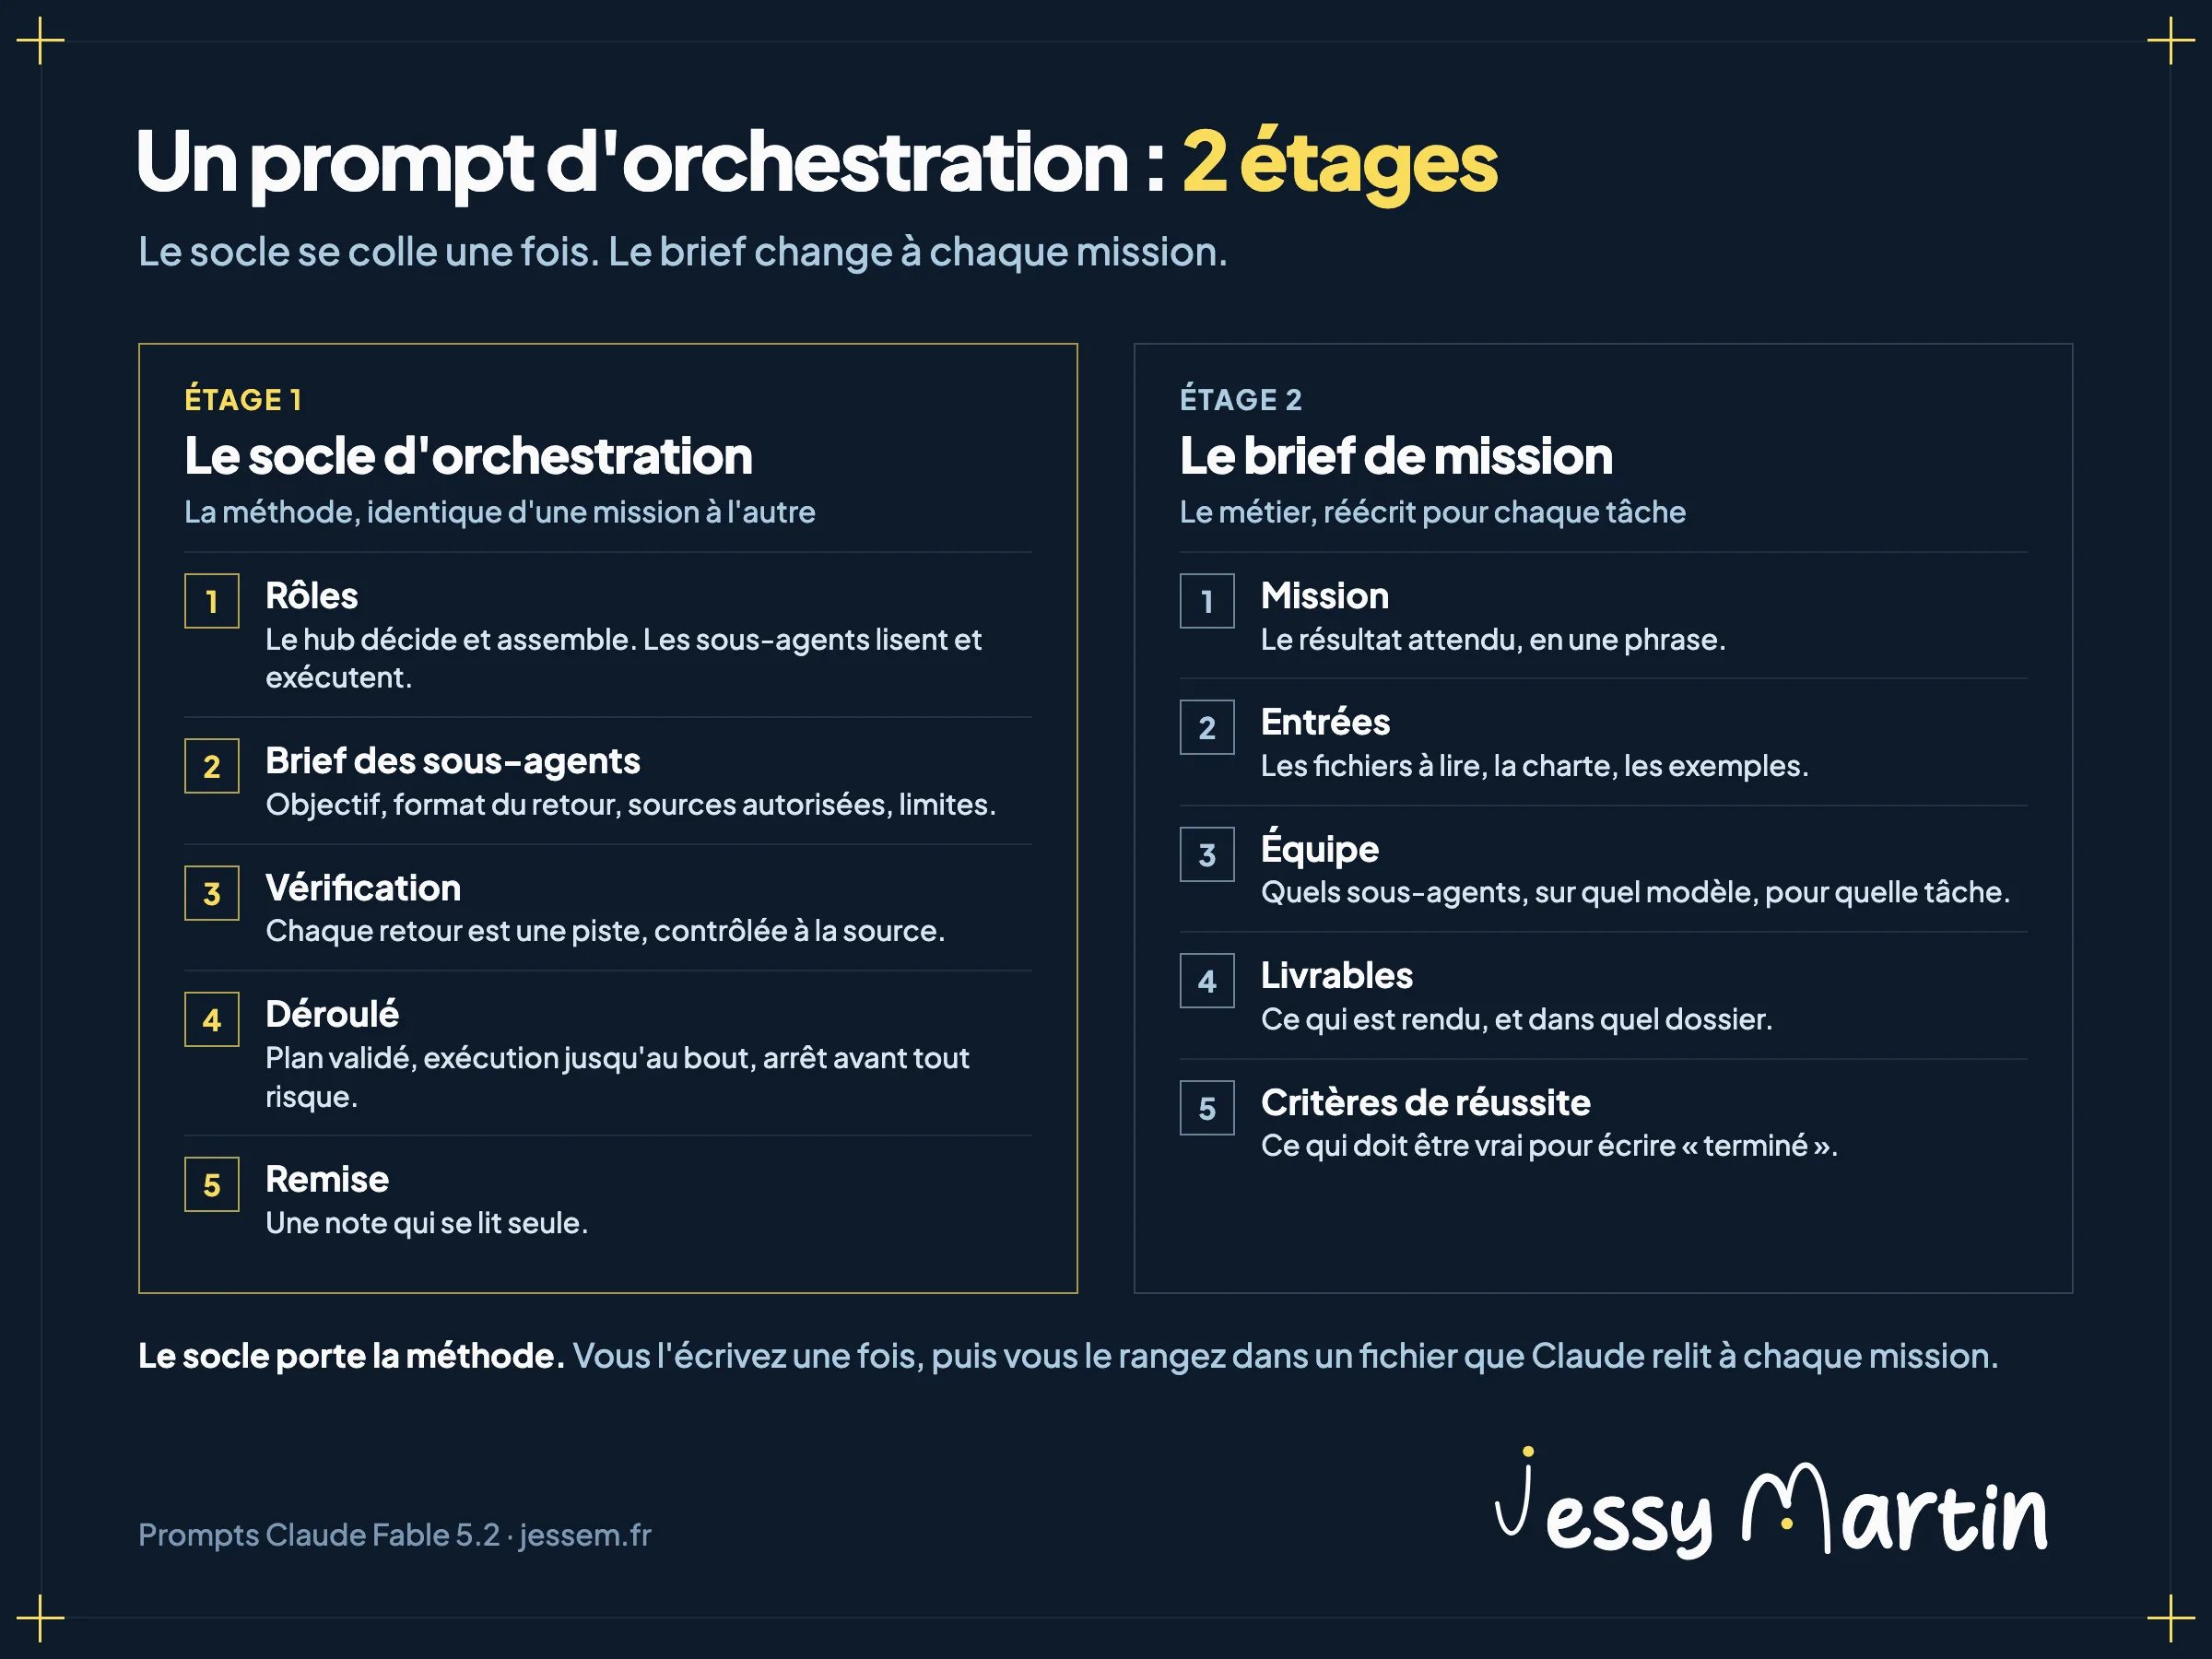
Le socle reprend les 6 règles et les formulations du guide officiel.
Tu es l'orchestrateur de cette mission. Le projet est le tien : sa
structure et ses choix te reviennent.

RÔLES
- Toi : le plan, les décisions, la vérification et l'assemblage final.
- Tes sous-agents : la lecture, la collecte, les premiers jets, les tests.
  Lance-les sur un modèle plus léger (Haiku pour lire et contrôler,
  Sonnet pour produire), en parallèle quand leurs tâches sont
  indépendantes.
- Taille de l'équipe : 1 sous-agent pour un fait simple, 2 à 4 pour une
  comparaison. Au-delà de 8, demande mon accord.

BRIEF DE CHAQUE SOUS-AGENT
Donne-lui 4 choses : son objectif, le format exact de son retour, les
fichiers et les sources autorisés, ce qui sort de son périmètre.
Il ne connaît que ce brief : écris-le pour quelqu'un qui n'a rien vu.

VÉRIFICATION
Traite chaque retour comme une piste. Avant de t'en servir, vérifie
toi-même dans la source les chiffres et les citations.

DÉROULÉ
1. Présente-moi ton plan : étapes, sous-agents prévus, ce que chacun
   rendra. Attends mon accord.
2. Exécute jusqu'au bout. Devant un obstacle ordinaire (erreur, fichier
   manquant, outil en échec), cherche la cause et contourne-le.
3. Arrête-toi avant toute action risquée ou irréversible.

REMISE
Termine par une note qui se lit seule : ce qui est fait, ce que tu as
vérifié et comment, ce qui reste incertain, ce que je dois relire en
premier.
Rangez ce socle dans un fichier à part, orchestration.md, et ouvrez chaque mission par « Lis orchestration.md ». Le fichier CLAUDE.md du projet est chargé aussi par les sous-agents, qui se prendraient pour le chef d'orchestre.
Les 10 briefs qui suivent sont construits à partir du guide officiel, de la documentation des sous-agents et de ce que mes agents produisent chaque semaine avec Claude Code. Les durées et les coûts mesurés sur Fable 5.2, brief par brief, viendront dans une mise à jour. Les crochets sont à remplacer.
3 prompts pour produire des contenus
1. Une étude devenue campagne complète
Quand : une étude ou un livre blanc dort dans un dossier. À préparer : le PDF, votre charte, 3 contenus qui vous ressemblent.
MISSION
Tire de l'étude sources/[etude].pdf une campagne complète pour
[MA CIBLE].

ENTRÉES
L'étude, graphiques compris. Ma charte : doctrine-de-marque.md.
3 contenus qui me ressemblent : contenus/exemples/.

ÉQUIPE
- Lecteurs (Haiku) : un par chapitre. Retour : une fiche de faits,
  chaque chiffre avec sa page.
- Toi : tu choisis les 5 chiffres porteurs et l'angle de la campagne.
- Rédacteurs (Sonnet) : un par canal, lancés après ton choix.
- Relecteur de marque (Sonnet) : confronte chaque texte à la charte.

LIVRABLES, dans contenus/campagne-[nom]/
Une note d'une page (les 5 chiffres et leur page), un article de
900 mots, 4 posts LinkedIn aux angles différents, 3 emails, le plan
d'un carrousel de 8 pages.

CRITÈRES DE RÉUSSITE
Chaque chiffre publié se retrouve dans l'étude, à la page indiquée :
tu l'as vérifié toi-même. Aucun canal ne reprend une phrase d'un autre.
Le relecteur ne signale plus d'écart avec la charte.
Pourquoi cette équipe : les lecteurs parcourent l'étude en parallèle pour une fraction du prix. Le choix des 5 chiffres reste au hub, parce que c'est la décision qui fait la campagne.
2. Un trimestre de contenus tiré de vos archives
Quand : le calendrier du trimestre est vide. À préparer : vos contenus publiés dans un dossier, un export de leurs statistiques.
MISSION
Bâtis mon calendrier éditorial des 12 prochaines semaines et rédige
les 4 premiers contenus.

ENTRÉES
Mes contenus publiés : contenus/publies/. Leurs statistiques :
sources/stats-[periode].csv. Ma charte : doctrine-de-marque.md.

ÉQUIPE
- Lecteurs (Haiku) : un par lot de 20 contenus. Retour : un tableau
  sujet, angle, format, date.
- Analyste (Sonnet) : croise ce tableau avec les statistiques. Retour :
  ce qui a été lu, ce qui a été ignoré, ce qui n'a jamais été traité.
- Toi : tu arrêtes les 12 sujets et tu me les présentes avant d'écrire.
- Rédacteurs (Sonnet) : un par contenu, après mon accord sur les sujets.

LIVRABLES
Le calendrier en tableau Excel (un sujet par semaine, son angle, son
format, la preuve sur laquelle il s'appuie) et 4 contenus rédigés.

CRITÈRES DE RÉUSSITE
Chaque sujet s'appuie sur un chiffre de mes statistiques ou sur un
manque constaté dans mes archives. Aucun sujet ne répète un contenu
déjà publié.
Pourquoi cette équipe : ce brief ajoute un point d'arrêt. Les 12 sujets passent par vous avant qu'un seul rédacteur démarre.
3. Une vidéo de présentation écrite en code
Quand : une offre à présenter, sans budget de tournage. À préparer : votre charte, votre logo, la description de l'offre. La méthode complète est dans Motion design avec Claude Code et HyperFrames.
MISSION
Réalise une vidéo de 30 secondes qui présente [MON OFFRE] à
[MA CIBLE], en HTML animé rendu en MP4 avec HyperFrames.

ENTRÉES
Ma charte (couleurs, polices, logo) : [DOSSIER].
L'offre : contenus/[offre].md.

ÉQUIPE
- Toi : le réalisateur. Tu écris le script en 5 plans et tu attends
  mon accord.
- Intégrateur (Sonnet) : construit les plans en HTML animé.
- Contrôleur (Haiku) : capture une image par plan et mesure ce qui
  déborde du cadre, les textes affichés moins de 2 secondes, les
  couleurs hors charte. Retour : une liste d'écarts, plan par plan.

LIVRABLES
Le script validé, le MP4, la liste des écarts corrigés.

CRITÈRES DE RÉUSSITE
Le contrôleur ne relève plus aucun écart. Tu as regardé toi-même la
dernière capture de chaque plan avant de livrer.
Pourquoi cette équipe : celui qui construit et celui qui contrôle sont 2 agents différents. Un agent juge mal son propre travail.
2 prompts pour analyser
Fable 5.2 lit mieux les graphiques. Sur Chartography, un test de lecture de graphiques, il obtient 73,4 %, contre 44,8 % pour Fable 5.1, d'après la page du modèle. Dans une analyse, cette lecture reste donc au hub.
4. Une revue de performance à partir de vos tableaux de bord
Quand : les graphiques sont là, le commentaire reste à écrire. À préparer : des captures de vos tableaux de bord et les exports qui vont avec.
MISSION
Fais la revue de performance marketing de [PÉRIODE] et sors
3 décisions.

ENTRÉES
Les captures de mes tableaux de bord : sources/captures/.
Les exports : sources/exports/ (CSV ou Excel).

ÉQUIPE
- Toi : tu lis toi-même les graphiques des captures et tu relèves
  chaque valeur avec son unité. C'est ton point fort, garde-le.
- Analystes (Haiku) : un par export. Retour : les totaux, les 5 plus
  fortes hausses et les 5 plus fortes baisses, avec le nom de la
  colonne.
- Vérificateur (Sonnet) : recalcule 5 chiffres pris au hasard, à
  partir des fichiers bruts.

LIVRABLES
Une page : ce qui progresse, ce qui décroche, 3 décisions pour le
mois, chacune appuyée sur un chiffre et sa source.

CRITÈRES DE RÉUSSITE
Les valeurs lues sur les captures et celles des exports se recoupent,
ou l'écart est signalé. Une valeur illisible est écrite comme
illisible.
Pourquoi cette équipe : 2 sources indépendantes, les captures et les exports, se contrôlent l'une l'autre. Le vérificateur ne connaît pas les conclusions du hub.
5. Un rapport de performance lu dans la Search Console
Quand : avant un plan SEO. À préparer : Claude Code dans l'application de bureau, et votre connexion à la Search Console dans son navigateur.
MISSION
Rédige le rapport de performance de [MON SITE] sur 3 mois, avec
10 priorités classées par gain attendu.

ENTRÉES
Ma Search Console, ouverte dans le navigateur de l'application : je
valide la connexion. Le dépôt du site : sitemap.xml et les pages.

ÉQUIPE
- Toi : tu pilotes seul le navigateur et tu relèves les tableaux
  (pages, requêtes, indexation, 28 derniers jours contre les
  28 précédents). Un navigateur ne se partage pas entre agents.
- Analystes (Sonnet) : un par groupe de requêtes, à partir des
  tableaux que tu leur transmets. Retour : les pages vues et peu
  cliquées.
- Contrôleur d'indexation (Haiku) : pour chaque page non indexée,
  cherche dans le dépôt sa présence au sitemap et ses liens entrants.

LIVRABLES, dans contenus/rapports/
Le rapport : vue d'ensemble, pages, requêtes par groupe, indexation,
10 priorités.

CRITÈRES DE RÉUSSITE
Chaque chiffre vient d'un tableau que tu as lu. Toute estimation est
marquée comme telle. Chaque page non indexée a une cause probable.
J'ai lancé une première version de cette mission sur jessem.fr le jour où j'écris ces lignes, sans sous-agents. Fable 5.2 a lu 174 lignes de pages et 1 000 requêtes dans ma Search Console, puis classé 10 priorités. La cause des pages non indexées, page par page, est partie dans une seconde session. C'est le rôle que ce brief confie au contrôleur d'indexation.
Avant de confier un export de CRM ou des avis clients à un modèle, retirez les données personnelles : la méthode est dans IA et RGPD : anonymiser vos données. D'après la page du modèle, Fable exige par défaut une conservation des données de 30 jours pour la surveillance de sécurité.
2 prompts pour créer une page web ou une application
Ce site est construit avec Claude Code, et j'ai décrit la méthode dans Créer un site web avec Claude Code. Un bon prompt Claude pour créer un site web tient en 3 choses : une référence de design, une structure, et un contrôle du rendu confié à un autre agent que celui qui construit.
6. Une landing page relue par un agent de design
Quand : une offre à mettre en ligne cette semaine. À préparer : votre charte, une page de référence, l'offre et ses preuves.
MISSION
Construis la landing page de [MON OFFRE] pour [MA CIBLE], en HTML et
CSS, dans landing/.

ENTRÉES
Ma charte : doctrine-de-marque.md. La page de référence :
[URL OU FICHIER]. L'offre et ses preuves : contenus/[offre].md.

ÉQUIPE
- Éclaireur (Haiku) : lit la page de référence. Retour : la fiche de
  ses couleurs, polices, espacements et composants.
- Toi : tu écris la structure et le texte. Sections : promesse,
  problème, solution, preuves, questions fréquentes, appel à l'action.
- Intégrateur (Sonnet) : construit la page à partir de ta structure
  et de la fiche de l'éclaireur.
- Relecteur de design (Sonnet, en lecture seule) : compare les
  captures de la page à la référence, en largeur ordinateur et en
  largeur téléphone.

LIVRABLES
La page, 2 captures finales, la liste des écarts corrigés.

CRITÈRES DE RÉUSSITE
Aucun chiffre ni témoignage inventé : [À COMPLÉTER] là où une preuve
manque. Rien ne déborde ni ne se chevauche sur les 2 largeurs. Le
relecteur ne relève plus d'écart avec la référence.
Pourquoi cette équipe : le relecteur travaille en lecture seule. Il signale, l'intégrateur corrige, et la boucle tourne jusqu'à zéro écart. La suite du travail est dans Créer une landing page avec Claude Code.
7. Un simulateur testé par un agent qui n'a pas vu le code
Quand : un calcul que vous refaites à chaque rendez-vous. À préparer : vos formules, même approximatives.
MISSION
Crée un simulateur en une page HTML : [CE QU'IL CALCULE].

ENTRÉES
Mes formules, même approximatives : [FICHIER OU TEXTE].
Entrées du simulateur : [LISTE]. Sorties : [LISTE].

ÉQUIPE
- Toi : tu écris les formules dans un tableau et tu attends ma
  validation.
- Développeur (Sonnet) : code la page. Les sorties se mettent à jour
  à chaque saisie. Aucune donnée ne quitte le navigateur.
- Testeur (Haiku) : travaille sans lire le code. Il calcule à la
  main, à partir des formules validées, les résultats attendus de
  5 cas, dont 2 cas limites (zéro, valeur très grande), puis les
  compare à ceux de la page.

LIVRABLES
La page, le tableau des formules validées, le tableau des 5 cas
(attendu, obtenu).

CRITÈRES DE RÉUSSITE
Les 5 cas concordent. Un écart remonte chez toi avant de revenir au
développeur.
Pourquoi cette équipe : un testeur qui lit le code en reproduit les erreurs. Celui-ci repart des formules que vous avez validées.
2 prompts pour un jeu ou une expérience de marque
D'après la page du modèle, Fable 5.2 est le meilleur modèle d'Anthropic pour concevoir des objets, dans le monde réel comme à l'écran : mondes 3D interactifs, simulations, animations et vidéos pédagogiques écrites en code.
Pour un jeu de marque, visez court : une mécanique et 60 secondes, avec votre message à la fin.
8. Un mini-jeu aux couleurs de votre marque
Quand : un salon ou un lancement à animer. À préparer : vos couleurs, votre mascotte ou votre produit en image.
MISSION
Crée un mini-jeu original, jouable dans le navigateur, en un seul
fichier HTML, aux couleurs de ma marque.

ENTRÉES
Mes couleurs, ma police, ma mascotte ou mon produit : [FICHIERS].
Le message de campagne : [MESSAGE]. Le bouton final mène à : [URL].

ÉQUIPE
- Toi : le concepteur. Tu écris les règles en 10 lignes (une
  mécanique, des parties de 60 secondes, un score) et tu attends mon
  accord.
- Développeur (Sonnet) : code le jeu. Clavier sur ordinateur, toucher
  sur téléphone. Aucun compte, aucune donnée collectée.
- Testeur (Haiku) : joue 3 parties dans le navigateur. Retour : ce
  qui bloque, ce qui est injouable au doigt, le score atteint.
- Relecteur de marque (Haiku) : contrôle les couleurs, le message de
  fin, et l'originalité des règles et des graphismes.

LIVRABLES
Le fichier du jeu, les règles validées, le compte rendu des 3 parties.

CRITÈRES DE RÉUSSITE
Une partie se joue du début à la fin sur ordinateur et sur téléphone.
Les règles et les graphismes sont les tiens : aucun emprunt à un jeu
existant.
Pourquoi cette équipe : vous validez 10 lignes de règles avant qu'une seule ligne de code soit écrite. C'est le point d'arrêt le moins cher du projet.
9. Une scène 3D de votre produit ou de votre lieu
Quand : un produit ou un lieu qui se comprend mieux en tournant autour. À préparer : quelques photos sous plusieurs angles.
MISSION
Construis une scène 3D interactive de [MON PRODUIT OU MON LIEU], en
un fichier HTML, avec Three.js.

ENTRÉES
[N] photos sous plusieurs angles : sources/photos/. 3 arguments à
montrer : [ARGUMENT 1], [ARGUMENT 2], [ARGUMENT 3].

ÉQUIPE
- Toi : tu regardes toi-même les photos et tu décris les volumes, les
  proportions et les couleurs. Tu compares ensuite chaque capture de
  la scène aux photos.
- Intégrateur (Sonnet) : construit la scène. Le visiteur tourne
  autour à la souris ou au doigt. 3 points cliquables ouvrent chacun
  une fiche.
- Testeur (Haiku) : mesure l'affichage à largeur de téléphone et
  signale ce qui saccade.

LIVRABLES
Le fichier de la scène, 3 captures comparées aux photos, la liste de
ce qui reste approximatif.

CRITÈRES DE RÉUSSITE
Les proportions et les couleurs tiennent face aux photos. La scène
tourne sans saccade sur un téléphone récent.
Pourquoi cette équipe : comme pour les graphiques, le regard reste au hub. Comparer une capture à une photo est ce que ce modèle fait mieux que ses rayons.
1 prompt pour confier un projet entier
C'est le test du Remote Labor Index, sur votre propre projet. Ici, le hub compose lui-même son équipe.
10. Un projet confié comme à un freelance
Quand : vous alliez envoyer ce brief à un prestataire. À préparer : le brief complet et les fichiers que vous lui auriez transmis.
MISSION
Tu reçois ce brief comme un freelance le recevrait :
[COLLER LE BRIEF : contexte, objectif, public, livrables, format, date].

ENTRÉES
Les fichiers que j'aurais transmis à un prestataire : [DOSSIER].

AVANT DE COMMENCER
Pose-moi au plus 5 questions sur ce qui manque au brief.

ÉQUIPE
Compose-la toi-même. Dans ton plan, donne pour chaque sous-agent son
rôle, son modèle (Haiku pour lire, Sonnet pour produire) et ce qu'il
te rendra.

LIVRABLES, dans livrables/
Tous ceux du brief, et une note de remise : ce qui est fait, tes
choix, ce que tu as vérifié toi-même, ce que je dois relire avant
l'envoi au client.

CRITÈRES DE RÉUSSITE
Un client accepterait ce livrable d'un professionnel. C'est le
critère du Remote Labor Index.
Pourquoi cette équipe : lisez le plan avant de dire oui. Le nombre de sous-agents et leur modèle vous disent ce que la mission va coûter.
Fable 5.2 ou Opus 5.5 : lequel utiliser
Anthropic l'écrit sur la page du modèle : pour le travail courant, commencez par Opus 5.5. Fable 5.2 sert aux projets techniques ambitieux et ouverts.
Le prix va dans le même sens. D'après les tarifs de l'API, Fable 5.2 coûte le double d'Opus 5.5 : 8 $ par million de tokens en entrée, contre 4 $.
Velox Themes a fait générer 18 landing pages, 9 par modèle, avec les mêmes prompts. Sur un prompt court, Fable 5.2 a mis 4,8 minutes et 2,18 $ par page en moyenne. Opus 5.5 a mis 2,6 minutes et 0,92 $. Avec un guide de design fourni, les pages des 2 modèles se ressemblaient.
La conclusion de l'auteur : le design fourni à l'IA a davantage pesé sur le résultat que le choix du modèle. C'est la raison d'être d'une charte de marque lisible par les agents.
| Votre besoin | Mon point de départ |
|---|---|
| Rédiger, résumer, répondre | Opus 5.5 seul |
| Une page simple avec une charte solide | Opus 5.5 seul |
| Une mission large, à lancer puis à retrouver terminée | Fable 5.2 en hub, Sonnet et Haiku en rayons |
| Des graphiques et des documents denses à lire | Fable 5.2 |
| Un jeu, une scène 3D, une application | Fable 5.2 en hub, Sonnet à l'intégration |
Si vous hésitez sur le premier chantier à ouvrir avec votre équipe, le diagnostic gratuit aide à le situer.
Le brief 10 est celui que je vous conseille de lancer en premier. Quel projet lui confieriez-vous ?
Construire et orchestrer vos propres agents marketing
La prochaine session Marketeur full stack : 21 heures pour construire et piloter vos agents sur votre propre production marketing, avec Claude Code.
Découvrir la session