Vous avez une charte graphique en PDF, un guide éditorial quelque part sur le Drive et une photothèque rangée par année. Un graphiste les lit et comprend. Un agent IA les lit et devine.
Tant que vous produisiez vous-même dans une fenêtre de chat, ce flou se corrigeait à la main, message après message. Le jour où vous confiez la production à un agent qui enchaîne les tâches seul, il se paie en heures de relecture.
Voici comment encoder vos éléments de marque (charte, ton, photos, logos, productions passées) pour qu'un agent les lise, s'en serve et se fasse contrôler. C'est la condition pour lui déléguer l'opérationnel sans y laisser votre identité. Et c'est aussi ce qui vous permet de changer d'IA le jour où vous le décidez.
Pourquoi les contenus IA de marque finissent par se ressembler
Un modèle de langage écrit la suite la plus probable. Sans consigne précise, la plus probable est la moyenne de tout ce qu'il a lu : le ton LinkedIn passe-partout, le bleu corporate, la photo de poignée de main.
Une charte classique aide peu. Elle est écrite pour un humain qui interprète : « un ton chaleureux mais expert », « des visuels lumineux ».
Votre graphiste sait ce que ça veut dire chez vous, parce qu'il a vu vos 3 dernières campagnes. L'agent n'a que la phrase.
S'y ajoutent 3 défauts que je croise souvent dans les dossiers de marque que j'audite :
- la même règle écrite à 2 endroits, en 2 versions qui ont divergé : l'agent applique celle qu'il lit en premier ;
- des renvois vers des documents qui n'existent plus : face à un fichier absent, l'agent improvise, sans prévenir ;
- aucune trace de ce qui a été refusé et pourquoi : l'agent reproduit les erreurs que vous avez déjà corrigées.
Le modèle suit ce qu'on lui donne à lire. Le travail consiste donc à lui donner une marque lisible.
Les 4 couches d'une charte de marque lisible par une IA
Une marque mélange des règles de natures très différentes : une couleur se mesure, un ton se juge, un droit d'image se vérifie dans un contrat.
Rangées ensemble dans un PDF, elles deviennent toutes aussi floues les unes que les autres.
La séparation qui tient le mieux aujourd'hui découpe la marque en 4 couches, chacune avec son format et sa façon d'être vérifiée.
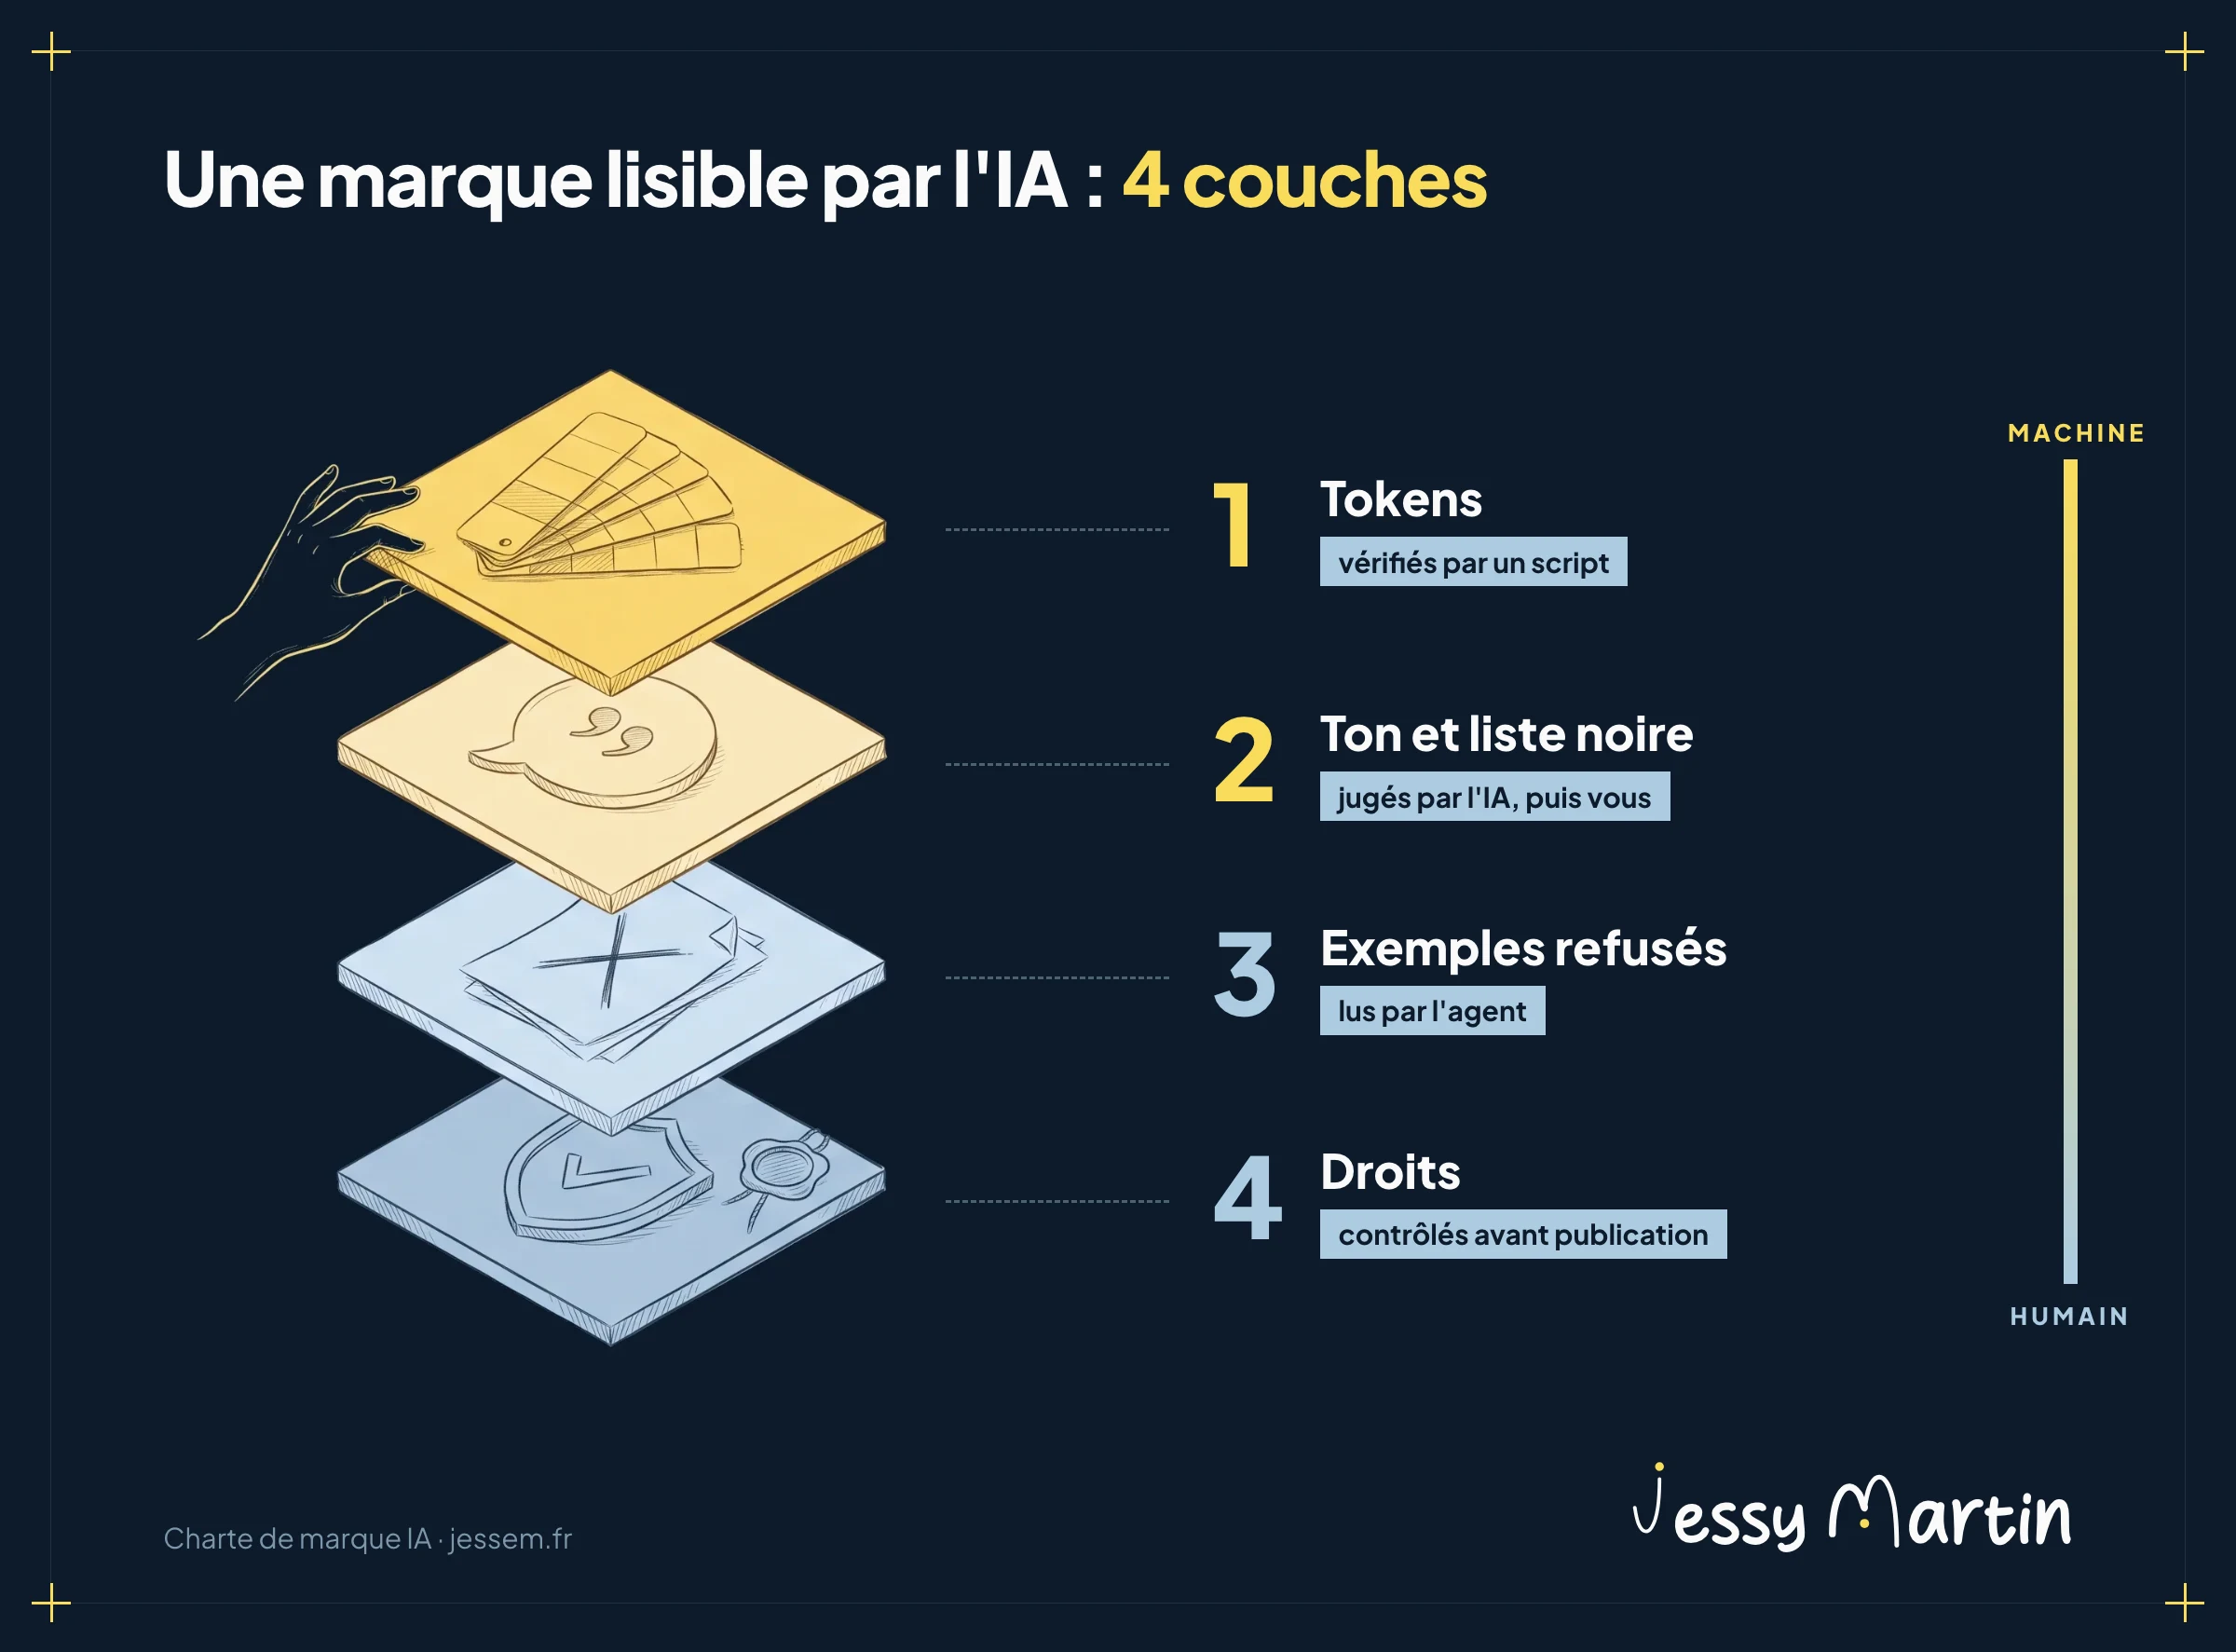
Ce qui se mesure sort de la charte et entre dans un fichier
Votre bleu de marque a sûrement 3 valeurs : un Pantone pour l'imprimeur, un CMJN dans le PDF, un hexadécimal dans le CSS du site. Un agent qui compose un visuel prend la première qu'il trouve.
La réponse s'appelle un design token : une valeur nommée, rangée dans un fichier que les outils savent lire.
Le format de référence est celui du Design Tokens Community Group du W3C, dont la première version stable date du 28 octobre 2025. Chaque token porte un nom, un type et une valeur. Il accepte aussi des informations en plus : l'usage, les supports où la couleur est admise, l'écart toléré.
Cet écart se mesure en ΔE, la différence de couleur perçue par l'œil. Autour de 1, elle est à peine visible. Un seuil de 2 par couleur laisse passer les petites variations d'export et arrête le bleu « presque pareil ».
Sans développeur, un tableau suffit pour démarrer : nom, valeur écran, valeur impression, usage, supports où la couleur est interdite. Si votre marque vit dans Figma, les variables s'exportent au format DTCG. Si elle vit dans un brand kit Canva ou Frontify, servez-vous en comme source et gardez votre fichier ouvert comme référence : vous pourrez changer d'outil sans réécrire la marque.
Le ton et la liste noire : un seul texte par sujet
Le ton se juge, il reste donc en prose. Et la prose a un défaut : elle se recopie. La consigne est collée dans le prompt des posts, puis dans celui de la newsletter, puis corrigée dans un seul des deux.
Écrivez un fichier par sujet (identité et positionnement, ton, liste noire, messages clés et preuves) et renvoyez vers lui partout ailleurs. Avant d'ajouter une règle, cherchez si elle existe déjà. Et vérifiez que chaque document cité dans vos consignes existe vraiment : c'est le contrôle le plus rentable d'un audit de marque pour agents.
La liste noire recense les mots et tournures que votre marque refuse, y compris les tics qui trahissent un texte généré. Écrivez-la avec des cas réels et une réécriture pour chacun. Un agent apprend mieux d'une correction que d'un interdit abstrait.
| Formulation refusée | Motif | Réécriture |
|---|---|---|
| « Révolutionnez votre communication » | vocabulaire de hype, aucune preuve | dire ce qui change, chiffre à l'appui |
| « Une solution simple, rapide et efficace » | 3 adjectifs creux, aucun fait vérifiable | nommer le résultat : « 2 jours de mise en place » |
| « Une marque parfaitement cohérente » | promesse impossible à tenir | « les écarts de couleur et de police sont repérés avant relecture » |
Les exemples refusés, la couche la plus négligée
Toutes les équipes gardent leurs contenus publiés. Rares sont celles qui gardent leurs refus.
Un contenu refusé, accompagné de la raison du refus, est pourtant l'exemple le plus instructif pour un agent.
« Logo posé sur un fond trop clair. » « Chiffre attribué à une étude qui ne le contient pas. » « Photo de banque d'images reconnaissable. » Sans motif, un rejet est un signal muet.
Tenez un fichier des rejets : l'extrait ou l'image, le motif, la règle enfreinte. Alimentez-le à chaque correction. L'agent le relit avant de produire.
2 précautions. Anonymisez les exemples : le prénom d'un client glissé dans un document interne peut ressortir dans un contenu publié. Et ne désignez jamais un contenu existant comme le modèle à imiter, sinon toutes les productions finissent par lui ressembler.
Les droits font partie de la marque
C'est la couche que presque personne n'encode, et la seule qui vous expose juridiquement.
Les polices d'abord. Les licences commerciales de fonderie interdisent souvent d'embarquer la police dans une application, ou de laisser des utilisateurs l'appliquer à leur propre texte.
Les polices publiées sous SIL Open Font License, comme la plupart des Google Fonts, sont libres d'usage, documents produits compris. Notez pour chaque police ce que sa licence permet.
Les photos ensuite : qui a pris l'image, qui y figure, sur quels canaux et jusqu'à quand vous pouvez l'utiliser. Le standard IPTC Photo Metadata range ces informations dans le fichier lui-même, et sa version 2025.1 ajoute des champs dédiés aux images générées par IA : le système utilisé, le prompt, son auteur.
Enfin, la provenance des images générées. La norme C2PA signe l'origine d'un fichier, mais de nombreuses plateformes suppriment ces métadonnées au moment de l'upload, comme le montre le cas de LinkedIn documenté par Fortune. Gardez donc à côté de chaque image générée une fiche de provenance : modèle, prompt, images de référence, date.
Côté loi, l'article 50 du règlement européen sur l'IA s'applique depuis le 2 août 2026.
Selon la FAQ de la Commission européenne, l'étiquetage d'un texte généré vise ceux publiés pour informer le public sur des sujets d'intérêt public, et tombe quand un humain le relit sous sa responsabilité éditoriale. Les hypertrucages doivent en revanche être signalés. Le détail est dans ce que le RGPD et l'AI Act exigent.
Photos, logos, visuels : ce que le texte ne sait pas transmettre
Le grain d'une photo, la direction de la lumière, la façon de cadrer un visage : aucune description ne les reproduit fidèlement. « Lumière naturelle chaude, cadrage serré » donne 10 images différentes en 10 générations.
Pour ces attributs, montrez. Choisissez 5 à 10 images d'ancrage qui résument votre direction artistique, et fournissez-les en référence au modèle d'image à chaque génération. Nano Banana Pro ou Seedream acceptent plusieurs images de référence dans une même demande.
Sur une chaîne longue (génération, retouche, agrandissement), réancrez à chaque étape : le style dérive un peu plus à chaque passage.
Pour la photothèque, l'agent a besoin d'un catalogue avant d'avoir besoin des fichiers. Une fiche par image ou par série : ce qu'elle montre, pour quel usage, avec quels droits, et son statut (à jour, obsolète, retirée).
L'agent lit le catalogue, choisit, puis transmet le fichier à l'outil par son chemin. Les images elles-mêmes restent hors de sa mémoire de travail, qu'elles satureraient.
Le logo, les titres et les chiffres arrivent après la génération. Les modèles d'image déforment les lettres, approximent les logos et inventent des nombres.
La méthode fiable : l'IA génère la scène, puis le vrai logo, les textes et les chiffres sont composés par dessus (en HTML, dans Figma ou dans Canva), avec vos polices. J'applique la même règle aux vidéos, comme dans ces 20 boucles générées sur Magnific.
Comment Claude ou Codex se servent de votre marque encodée
Un agent IA est un modèle qui agit : il lit des fichiers, appelle des outils et enchaîne les étapes jusqu'au livrable. Claude, dans Claude Code ou Cowork, et Codex d'OpenAI fonctionnent sur ce principe. Votre marque leur parvient par 3 canaux.
| Canal | Ce qu'il transporte | Exemple |
|---|---|---|
| Fichier d'instructions (CLAUDE.md, AGENTS.md) | ce que l'agent doit savoir à chaque tâche : où vit la doctrine, les règles non négociables | « avant tout visuel, lire les tokens et le catalogue d'assets » |
| Skills (SKILL.md) | une méthode par type de livrable, chargée seulement quand la tâche l'appelle | la skill « carrousel LinkedIn » lit les tokens, les rejets et les 3 derniers carrousels |
| Serveurs MCP | l'accès à vos outils de production | générer une image dans Magnific ou par l'API de Nano Banana, ouvrir un design Canva, lire un brand kit Frontify |
Anthropic cite le respect des guidelines de marque parmi leurs usages dès leur annonce du 16 octobre 2025. Et le format est partagé : Codex lit les mêmes fichiers SKILL.md, chargés de la même façon, à la demande.
Une doctrine de marque bien encodée passe d'un agent à l'autre sans réécriture.
Le protocole MCP relie l'agent à vos outils. Magnific, qui réunit les principaux modèles d'image et de vidéo (Nano Banana, Seedream, Imagen, Veo), propose un serveur MCP officiel : Claude y génère une image, une vidéo ou un son sans quitter la conversation. Canva, Figma et Frontify ont aussi le leur.
Et rien ne vous enferme dans une plateforme. Un agent peut appeler directement n'importe quelle API de génération d'images : Nano Banana chez Google, GPT Image chez OpenAI, ou le modèle qui sortira le mois prochain. Il suffit de lui donner la clé d'API et la documentation, et il écrit lui-même le petit script qui fait l'appel. Magnific garde l'avantage de réunir les modèles derrière un seul abonnement ; l'API directe donne la main sur chaque réglage et se paie à l'image.
Mis bout à bout, un visuel de campagne suit ce chemin.
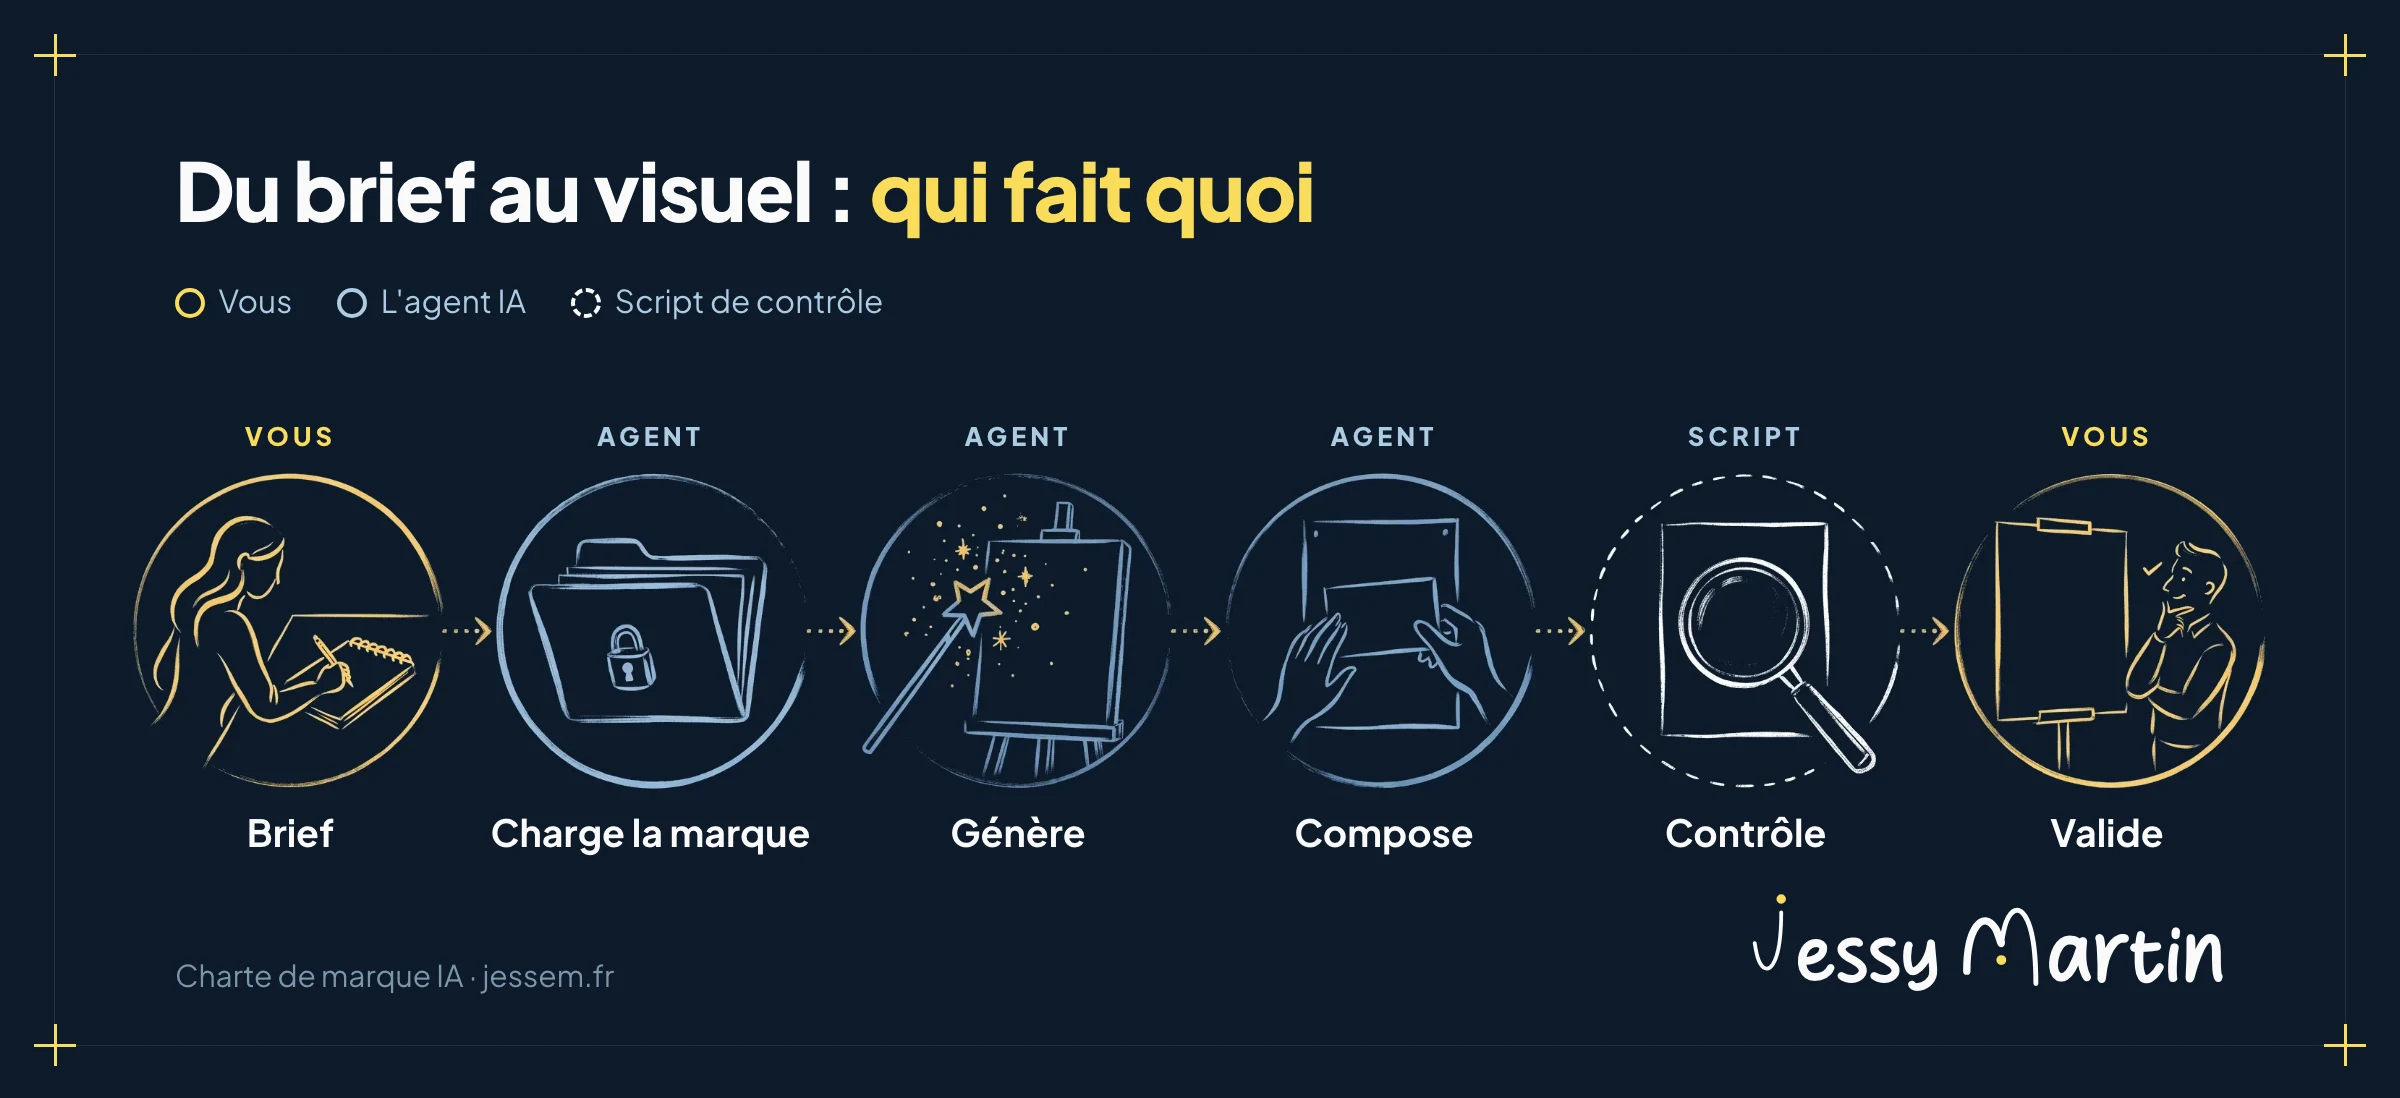
Votre relecture porte alors sur ce qui demande votre jugement. Les défauts mécaniques ont été arrêtés avant. Pour un exemple complet de production image et vidéo, voyez la vidéo IA créée avec Magnific et Dreamina.
Vos fichiers vous appartiennent : changez d'IA quand vous le décidez
Cette méthode a un effet que les équipes marketing voient rarement venir : elle vous rend indépendant des fournisseurs d'IA.
Votre marque encodée tient dans des fichiers texte, du markdown, du JSON et quelques scripts. Ils vivent où vous le choisissez : sur votre ordinateur, dans un dépôt GitHub privé, sur un serveur loué chez votre hébergeur, dans votre cloud.
Anthropic ou OpenAI les lisent le temps d'une tâche. La version de référence reste chez vous.
Comparez avec une marque rangée dans les projets d'une plateforme ou dans un brand kit propriétaire. Le jour où les prix montent ou où les conditions changent, tout est à reconstruire ailleurs.
Avec des fichiers, changer d'agent revient à pointer un autre outil vers le même dossier. Vos skills fonctionnent dans Claude Code comme dans Codex. Vos instructions tiennent dans un CLAUDE.md ou un AGENTS.md, le fichier que lisent Codex et de nombreux autres agents : 2 fichiers de même nature, qu'on recopie de l'un vers l'autre.
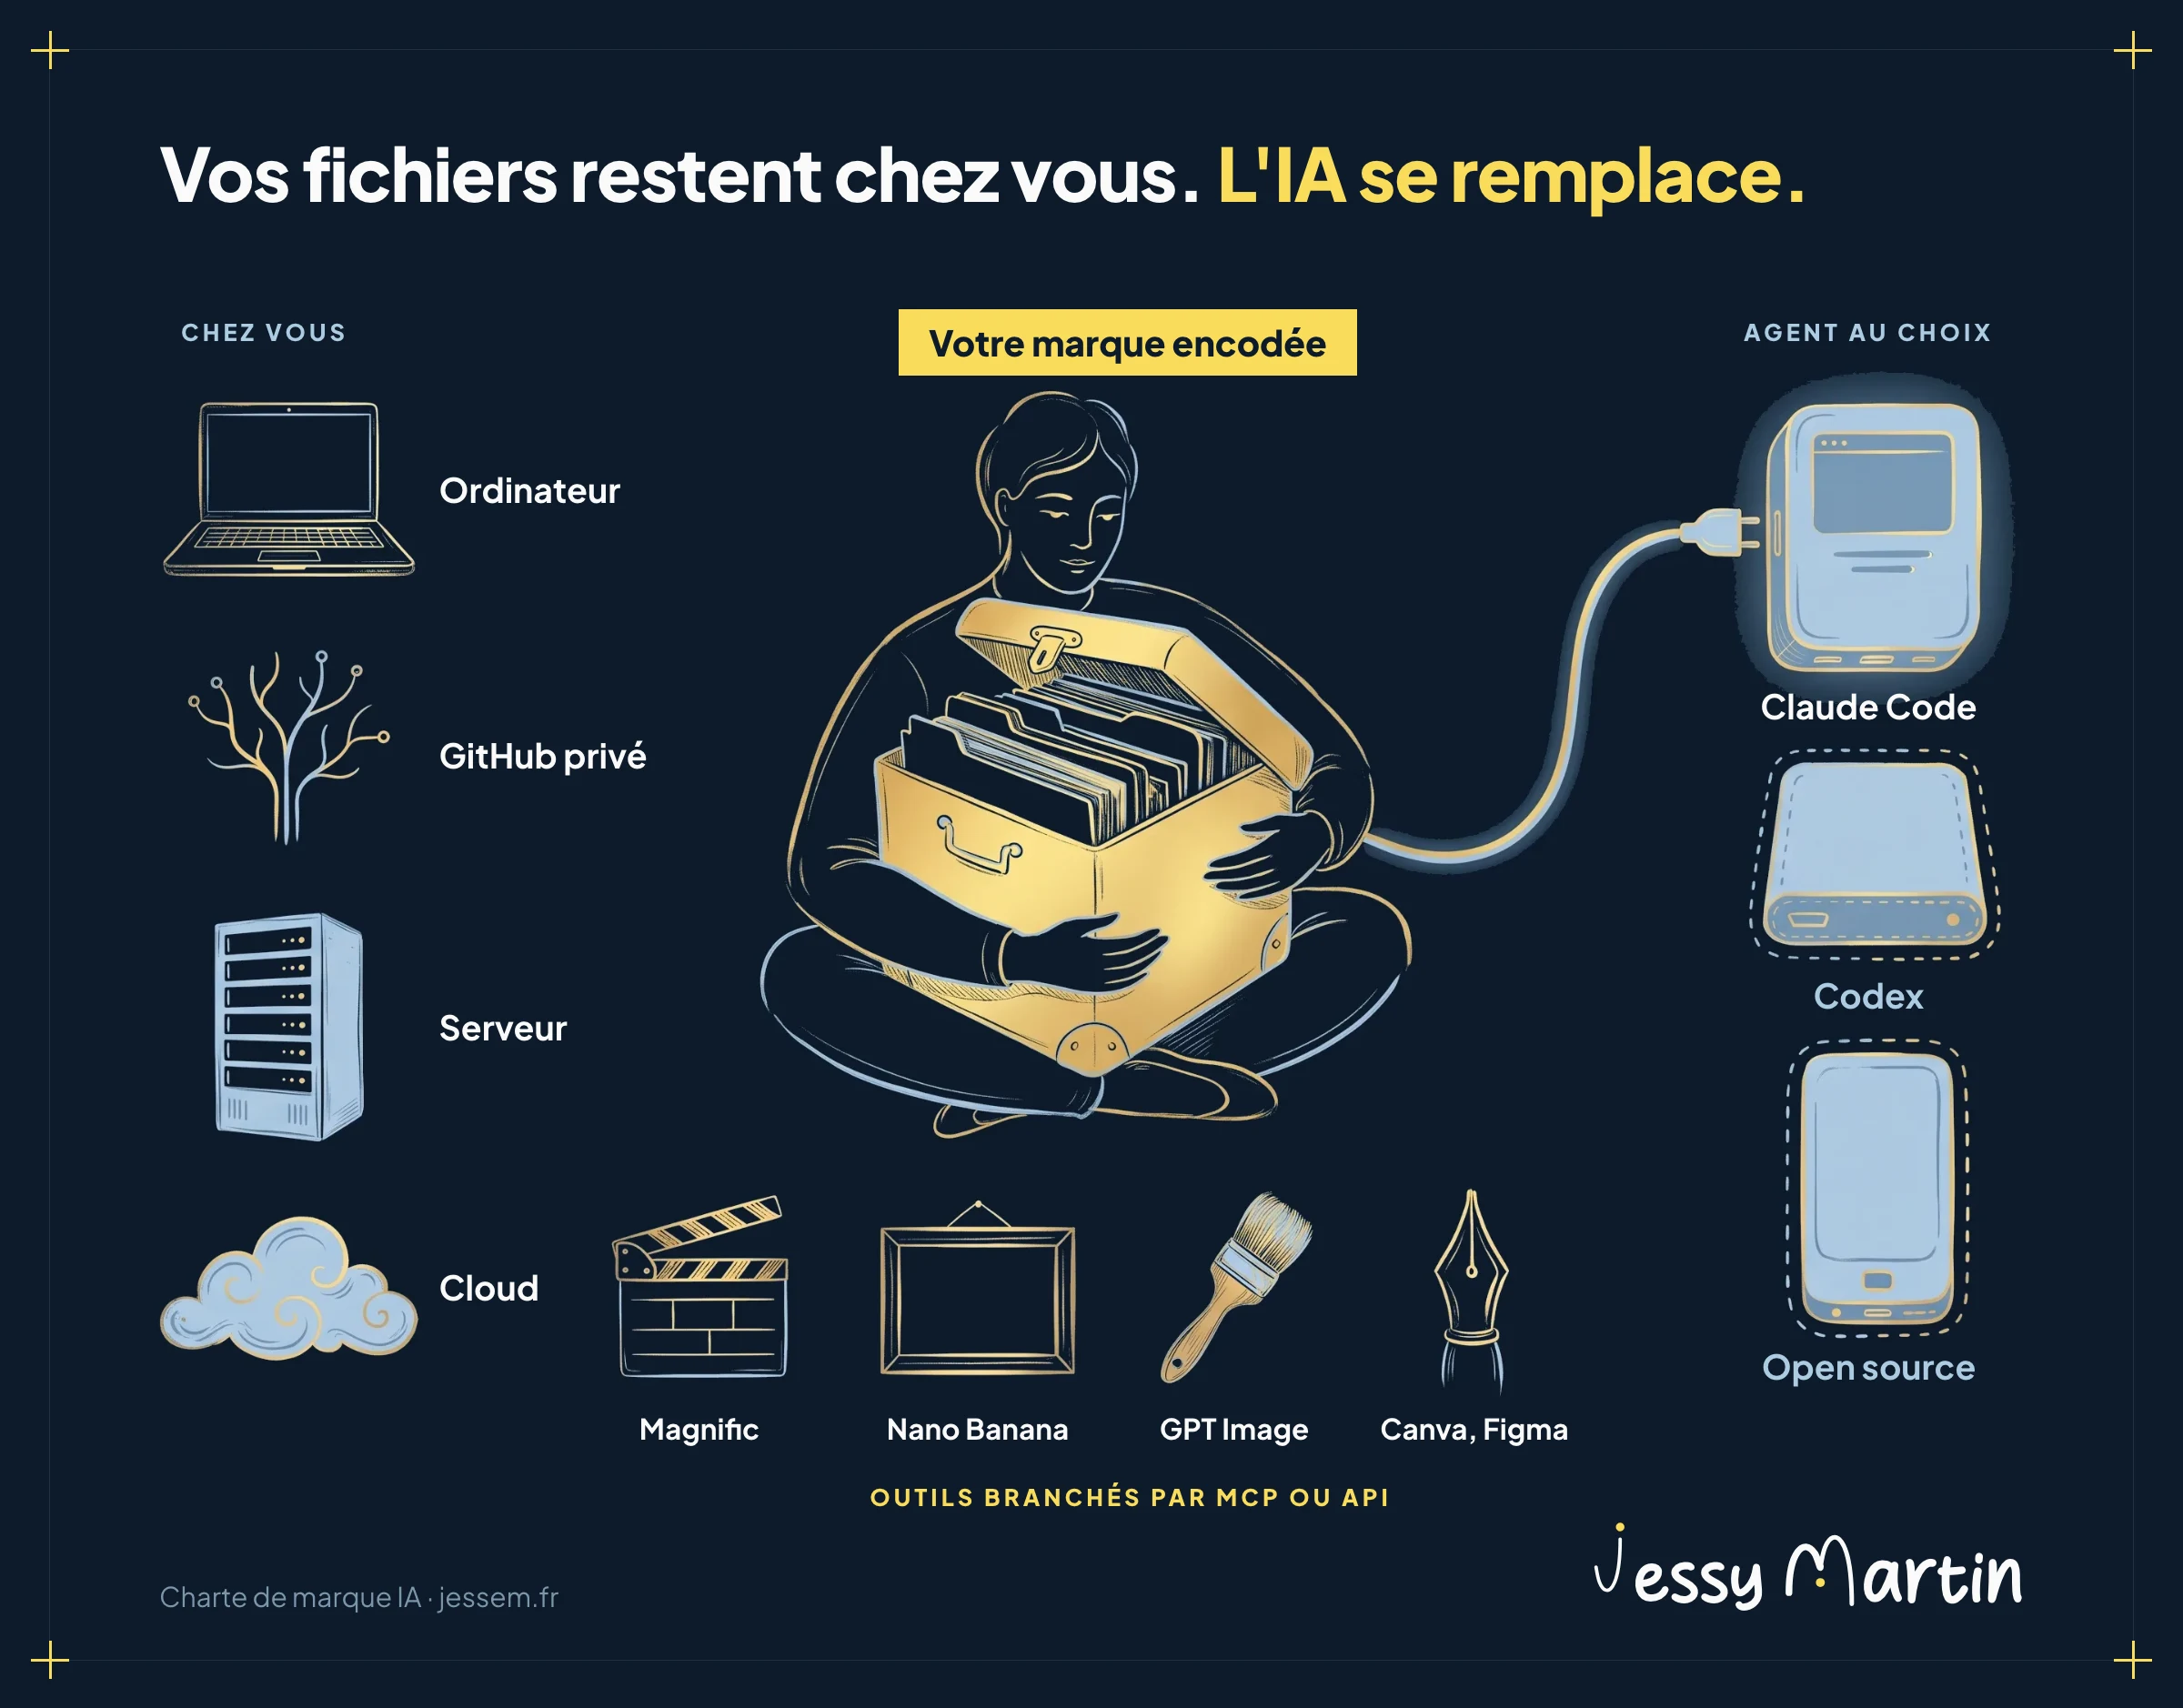
Le modèle lui-même devient remplaçable. OpenRouter donne accès à des centaines de modèles derrière une seule clé d'API, dont les modèles open source chinois, à des tarifs sans commune mesure avec les modèles fermés. Claude Code peut même y être branché en changeant 3 variables d'environnement.
| Modèle | Éditeur | Prix par million de tokens, entrée / sortie | Niveau annoncé |
|---|---|---|---|
| DeepSeek V4 Flash | DeepSeek, Chine | 0,054 $ / 0,242 $ | 79 % sur SWE-bench Verified |
| MiniMax M3 | MiniMax, Chine | 0,098 $ / 1,21 $ | proche de Claude Sonnet 4.6 sur un test agentique |
| GLM 5.2 | Z.ai, Chine | 0,447 $ / 3,31 $ | environ 5 points sous Claude Fable 5 sur l'indice Artificial Analysis |
Source : le panorama des modèles ouverts publié par OpenRouter le 27 juin 2026, tarifs moyens en dollars. Les prix bougent souvent.
Le schéma qui se dessine : un modèle haut de gamme pour construire et faire évoluer le système, un modèle bien moins cher pour la production courante, puisque la marque encodée porte une grande partie du travail.
3 réserves avant de basculer.
Les agents sont réglés pour leurs modèles maison : OpenRouter prévient lui-même que Claude Code peut mal fonctionner avec d'autres fournisseurs, et tous les modèles ne gèrent pas aussi bien l'appel d'outils.
La qualité rédactionnelle en français se teste sur vos propres livrables, avec votre linter de marque comme premier juge. Et un prix bas ne dit rien du chemin de vos données : vérifiez qui héberge le modèle avant d'y envoyer une information client, comme je le détaille pour la connexion d'une IA à votre CRM.
C'est ce que j'appelle reprendre la main sur ses outils. La doctrine vous appartient, et le modèle devient un fournisseur que vous choisissez tâche par tâche.
Contrôler automatiquement la cohérence de marque
Une règle écrite reste un rappel. Elle devient fiable le jour où un script la vérifie.
Un linter de marque est un petit programme qui relit chaque contenu produit et signale les écarts mesurables. Claude Code ou Codex peuvent l'écrire pour vous à partir de votre fichier de tokens et de votre liste noire, puis le lancer après chaque production.
| Contrôle | Ce qu'il attrape | Qui tranche |
|---|---|---|
| Mots et tournures interdits | le vocabulaire de hype, les tics d'écriture IA | script |
| Couleurs | une teinte à plus de ΔE 2 de la palette | script |
| Polices | une typographie hors marque, une police de secours affichée au rendu | script |
| Contraste | un texte sous le ratio WCAG 2.2 (4,5 pour 1 sur le corps de texte) | script |
| Champs à remplir | un « [NOM DU CLIENT] » oublié | script |
| Ton, preuve, pertinence | un texte propre sur la forme et faux sur le fond | modèle juge, puis vous |
| Cadrage, rythme d'une vidéo, droits ambigus | ce qu'aucun script ne sait juger | vous |
Partez des corrections que vous faites le plus souvent. Elles forment la liste des règles à automatiser, écrite par l'usage.
Un piège à connaître : un contrôle impossible à passer est vite ignoré. Si votre gabarit officiel échoue à la règle qu'il impose, l'agent apprend que l'alerte ne compte pas. Faites passer le contrôle à chaque gabarit avant de le distribuer.
Par où commencer dans votre équipe marketing
3 niveaux, et chacun rend service seul.
| Niveau | Outils | Ce que vous mettez en place |
|---|---|---|
| 1. Sans code | un projet Claude ou Cowork, des fichiers partagés | un fichier par sujet de marque, un fichier de rejets motivés, le tableau des couleurs et typographies, un registre des droits minimal, une checklist de relecture de 10 points |
| 2. Avec un agent | Claude Code ou Codex | une skill par type de livrable, un catalogue d'assets, un inventaire des contenus publiés, un linter sur vos 5 corrections les plus fréquentes |
| 3. Système vérifiable | tokens DTCG, serveurs MCP | des styles générés depuis les tokens, un contrôle mesuré sur le rendu des visuels, une fiche de provenance par image générée |
Le niveau 1 apporte le gain le plus visible : vous arrêtez de recoller votre contexte de marque à chaque conversation. J'en parlais dans pourquoi vos prompts IA oublient tout.
Et 3 chantiers peuvent attendre.
Entraîner un modèle sur votre style : des images de référence suffisent dans la plupart des cas. Inventer votre propre format de charte : le format DTCG couvre le besoin. Brancher un gestionnaire d'assets par MCP : si votre photothèque tient dans un catalogue bien tenu, il fait le travail.
Encoder votre marque en atelier ?
« Le cerveau de marque » arrive dans les ateliers du Cockpit : vous repartez avec votre doctrine encodée, lisible par Claude, et réutilisable dans tous les autres ateliers.
Découvrir les ateliers